「1人だけのソロ写真だけでなく、複数人が写った集合写真もきれいに自動仕分けしたい」
このような大量の写真整理を自動化したいとき、Pythonと機械学習の顔認識技術を組み合わせることで、完全ローカル環境で手動操作なしの一括フォルダ振り分けが実現できます。
本記事では、顔特徴量(Embedding)の数値化から、機械学習アルゴリズム「DBSCAN」によるクラスタリングの仕組み、集合写真に対応した実践コードまで、図解を交えて詳しく解説します。
Pythonによる顔認識クラスタリングの全体像
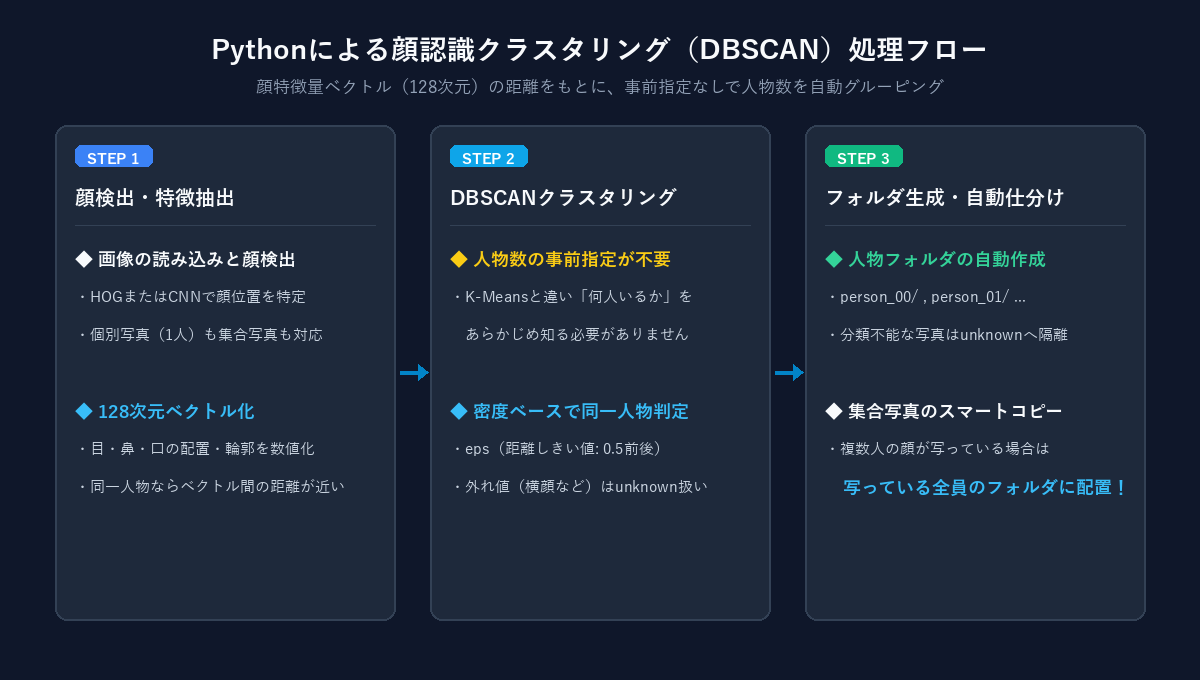
写真の人物分類を自動化する際、一般的な機械学習手法である「K-Means」ではなく「DBSCAN(Density-Based Spatial Clustering of Applications with Noise)」を採用するのには明確な理由があります。
- 人物数(クラスタ数)の事前指定が不要:K-Meansはあらかじめ「何人いるか」を指定する必要がありますが、写真フォルダ内に何人写っているかは事前に分かりません。DBSCANならデータの密度から人物数を自動判定します。
- 外れ値(ノイズ)の自動除外:ピンボケ写真、極端な横顔、照明が暗すぎる写真など、判定が困難な顔を無理に誰かのグループに入れず、「unknown(未分類)」として安全に隔離できます。
顔特徴量(Embedding)と距離計算の仕組み
AIは人間の顔をどのように見分けているのでしょうか。その核心となるのが「顔特徴量ベクトル(Face Embedding)」と「ユークリッド距離」です。
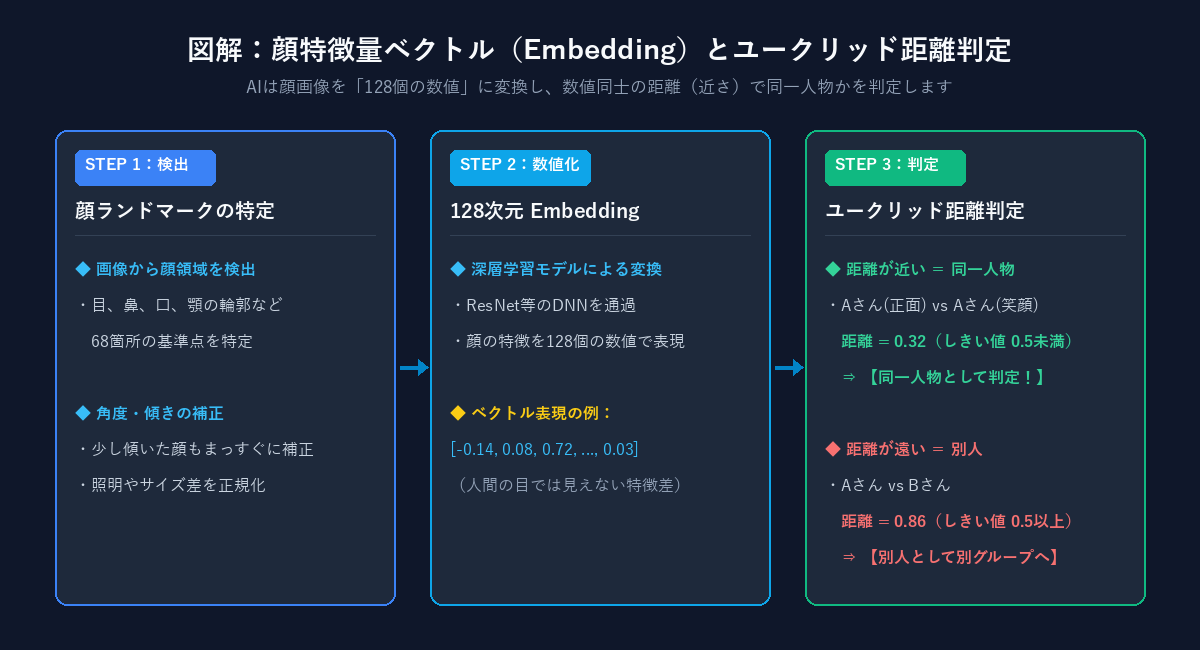
- 顔検出と基準点(ランドマーク)の特定:目・鼻・口・顎のラインなど68箇所の基準点を検出し、傾きを正面向きに補正します。
- 128次元の数値ベクトルに変換:深層学習モデル(ResNet等)を通すことで、顔の微細な特徴を「128個の数値の並び」に圧縮変換します。
- ユークリッド距離による判定:2つの顔ベクトルの距離を計算します。同じ人物であれば距離が近く(0.3〜0.4程度)、別人であれば距離が遠く(0.8以上)なります。このしきい値を通常「0.5前後」に設定することで同一人物判定を行います。
DBSCANクラスタリングの視覚的メカニズム
抽出された大量の顔特徴量を、2次元の空間に見立ててグループ化する様子を図解しました。
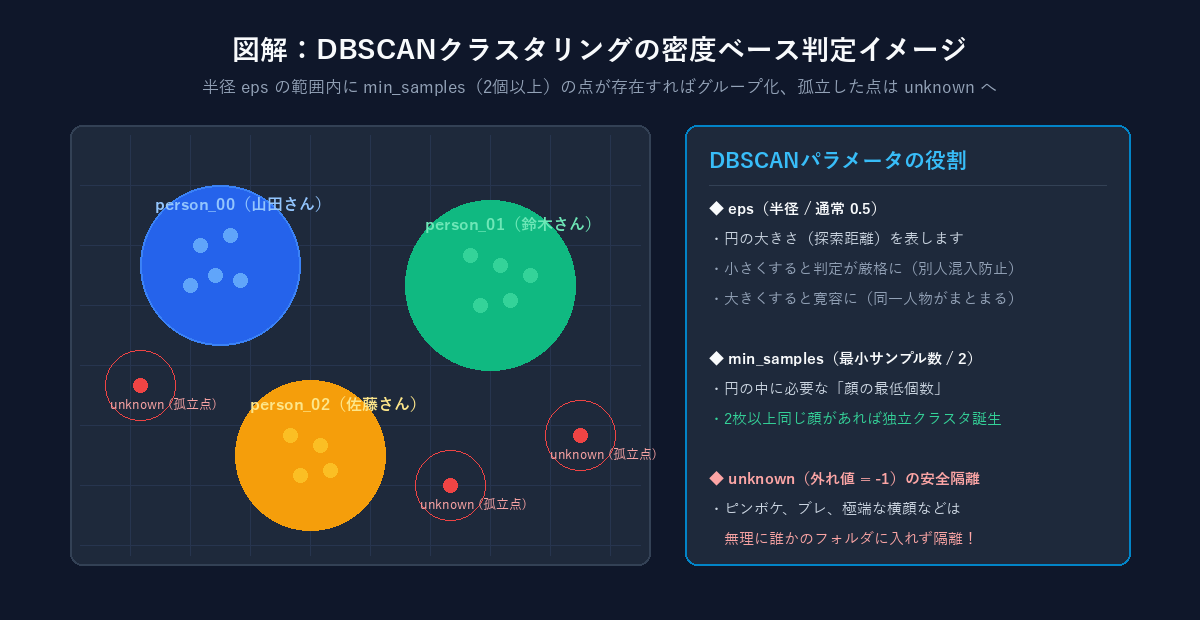
- eps(探索半径 / 通常 0.5):基準となる点から、同一グループとみなす「円の大きさ(距離)」です。
- min_samples(最小サンプル数 / 通常 2):グループとみなすために円の中に必要な「最低個数」です。2枚以上同じ人物の写真があれば独立した人物フォルダ(person_00, person_01等)が形成されます。
- unknown(孤立点 / 外れ値):ピンボケやブレ、1枚しか写っていないゲストなど、円の中に仲間がいない顔は自動的にノイズ(-1)として扱われ、unknownフォルダへ安全に隔離されます。
Windows環境でのライブラリ導入とエラー回避法
Pythonで顔認識を行う場合、Windows環境特有のビルドエラー対策が重要になります。
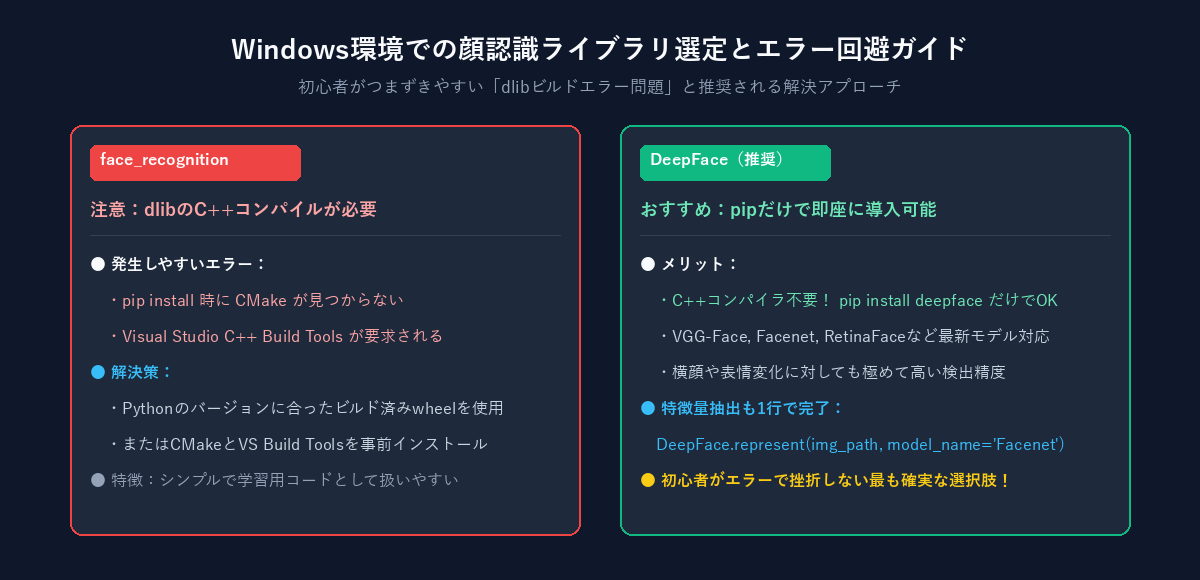
選択肢A:face_recognitionを使用する場合(dlibエラー対策)
標準的なインストールコマンドは以下のとおりです。
pip install face_recognition scikit-learn numpyface_recognitionの内部エンジンである「dlib」はC++で書かれており、WindowsではVisual Studio C++ Build ToolsとCMakeの環境がないとビルドに失敗します。
最も簡単な解決策は、Pythonのバージョンに対応したビルド済みのwheelファイル(.whl)を入手して直接インストールすることです。
例:pip install dlib-19.24.1-cp311-cp311-win_amd64.whl
選択肢B:DeepFaceを使用する場合(初心者におすすめ)
C++のコンパイル環境を整えるのが面倒な場合や、より手軽に高精度な顔認識を行いたい場合は「DeepFace」が非常に有力な選択肢です。
pip install deepface scikit-learn numpy集合写真にも対応した実践スクリプト
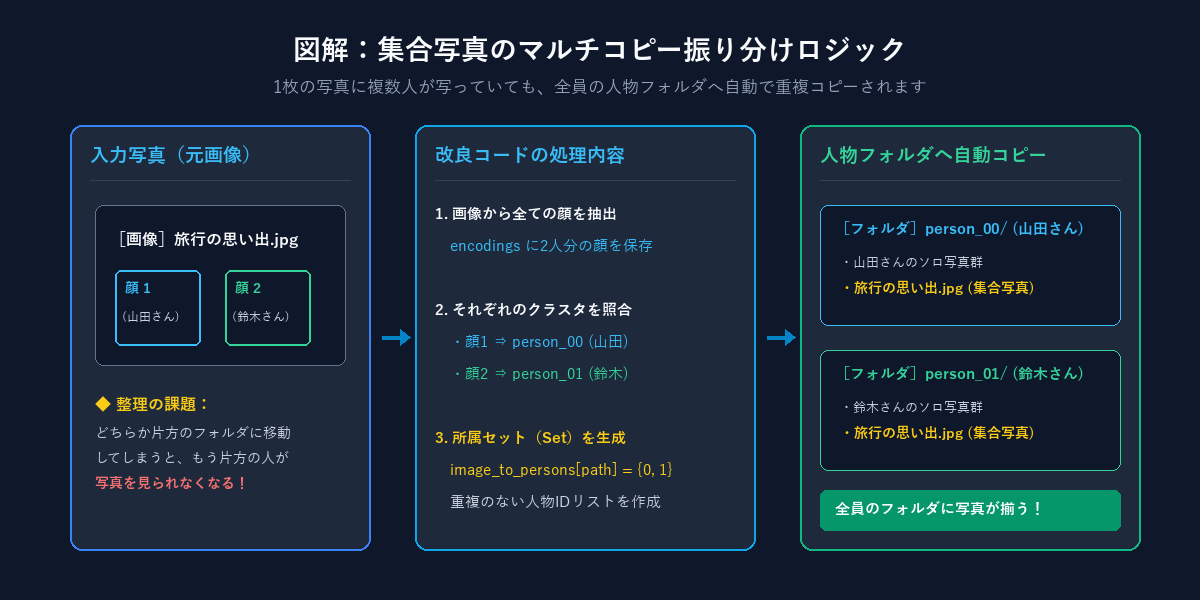
1枚の写真に複数人が写っている集合写真でも、写っている全員のフォルダへ自動で重複コピーする実践ロジックを図解とコードで示します。
import os
import shutil
import face_recognition
from sklearn.cluster import DBSCAN
import numpy as np

INPUT_DIR = "./photos"
OUTPUT_DIR = "./sorted_people"

valid_exts = (".jpg", ".jpeg", ".png", ".webp")

all_encodings = []
face_records = []  # 各顔の (画像パス, 顔インデックス)

print("顔検出および特徴抽出を開始します...")

# 1. すべての画像から、写っている「全顔」の特徴量を抽出
for filename in os.listdir(INPUT_DIR):
    if not filename.lower().endswith(valid_exts):
        continue

    path = os.path.join(INPUT_DIR, filename)
    image = face_recognition.load_image_file(path)
    encodings = face_recognition.face_encodings(image)

    # 集合写真も含め、検出されたすべての顔を登録
    for face_idx, enc in enumerate(encodings):
        all_encodings.append(enc)
        face_records.append((path, face_idx))

print(f"検出された総顔数: {len(all_encodings)}")

# 2. DBSCANクラスタリングを実行
if all_encodings:
    clt = DBSCAN(metric="euclidean", eps=0.5, min_samples=2)
    clt.fit(all_encodings)

    os.makedirs(OUTPUT_DIR, exist_ok=True)

    # 画像ごとに、属する人物ID(重複のない集合)をまとめる
    image_to_persons = {}
    for (path, _), label_id in zip(face_records, clt.labels_):
        if path not in image_to_persons:
            image_to_persons[path] = set()
        image_to_persons[path].add(label_id)

    # 3. 各人物フォルダへ振り分け(集合写真は写っている全員のフォルダへコピー)
    for path, person_labels in image_to_persons.items():
        filename = os.path.basename(path)
        for label_id in person_labels:
            folder_name = f"person_{label_id:02d}" if label_id != -1 else "unknown"
            target_folder = os.path.join(OUTPUT_DIR, folder_name)
            os.makedirs(target_folder, exist_ok=True)

            shutil.copy(path, os.path.join(target_folder, filename))

    print("すべての写真(個別・集合写真含む)の振り分けが完了しました!")
else:
    print("顔が検出された画像が見つかりませんでした。")
分類精度を高めるパラメータ調整のコツ
写真の撮影環境(照明、画質、被写体の年齢幅)に応じて、DBSCANのパラメータを調整することで分類精度が大きく向上します。
- eps(距離しきい値 / 標準: 0.5):
eps = 0.45(厳格判定):別人が同じフォルダに混ざるのを防ぎたい場合に設定。ただし同一人物でも別グループに分かれやすくなります。eps = 0.55(寛容判定):表情の違いや成長による変化も同一人物としてまとめたい場合に設定。
- min_samples(最小サンプル数 / 標準: 2):
同一人物とみなすための最小写真枚数です。「2」にしておくと、2枚以上同じ顔があれば独立した人物フォルダが作成されます。1枚しか写っていない人物は自動でunknownに分類されます。
まとめ
Pythonの「face_recognition」と「DBSCANクラスタリング」を活用すれば、事前に対象の人数を指定することなく、大量の写真フォルダから人物ごとに自動仕分けするシステムを簡単に構築できます。
特に集合写真への対応ロジックを組み込むことで、ソロ写真だけでなくグループ写真もしっかりと本人のフォルダに網羅できるようになります。完全ローカル環境で写真データを安全に整理したい方は、ぜひ本コードを活用してみてください。


