前回の記事「スプレッドシートでふりがなを自動取得するGASカスタム関数の解説」で取り上げた「よみたんAPI」の背後でも、日本語の読み仮名を取り出す中核エンジンとしてこのMeCabが活用されています。
「そもそも形態素解析とは何をしているのか?」「なぜMeCabはこれほど高速に日本語を分解できるのか?」「辞書にはどんな種類があるのか?」といった疑問をお持ちの方に向けて、MeCabの基本概念、コスト最小化のアルゴリズム、主要辞書の違い、Pythonでの動かし方、そしてLLM(大規模言語モデル)時代における重要性まで詳しく解説します。
形態素解析とは?日本語処理における最初の関門
コンピュータに人間の言葉(自然言語)を理解させる際、日本語には英語などの欧米言語にはない大きなハードルが存在します。それが「単語の区切り」です。
英語の場合、「This is a pen.」のように単語と単語の間があらかじめ半角スペースで区切られています(これを「わかち書き」と呼びます)。そのため、スペースを目印にすれば簡単に単語を分割できます。
しかし、日本語は「すもももももももものうち」のように、単語同士の間にスペースを挟まずに文字が連続して表記されます。どこからどこまでがひとつの単語なのか、コンピュータには一見して判別がつきません。
そこで登場するのが「形態素解析(Morphological Analysis)」です。
形態素解析とは、文章を意味を持つ最小の言語単位である「形態素(Morpheme)」に分割し、それぞれの品詞(名詞、動詞、助詞など)や活用形、原形、読み仮名などを特定する技術を指します。
- すもも(名詞)
- も(助詞)
- もも(名詞)
- も(助詞)
- もも(名詞)
- の(助詞)
- うち(名詞)
このように文章を分解して構造化することで、検索エンジンでのキーワード抽出、テキストの感情分析、機械翻訳、音声合成(読み上げ)などの高度な自然言語処理が可能になります。
MeCab(和布蕪)の誕生と名前の由来
「MeCab(和布蕪)」は、奈良先端科学技術大学院大学(NAIST)出身で、後にGoogleで日本語入力システムの開発などに携わった工藤拓(Taku Kudo)氏によって開発されたオープンソースの形態素解析エンジンです。
MeCabが登場する以前は、松本裕治氏の研究室で開発された「ChaSen(茶筌)」や「JUMAN」といった形態素解析器が主流でした。しかし、テキストの大規模化に伴い「より高速に、より少ないメモリで動作するエンジン」が強く求められるようになりました。
そこで、ChaSenの優れた思想を受け継ぎつつ、ゼロベースでC++によって高速化・最適化されて設計されたのがMeCabです。
「和布蕪(めかぶ)」というユニークな名前の由来
なぜ海藻の「めかぶ」という名前が付けられたのでしょうか。
開発者の工藤氏によれば、先行する解析器である「ChaSen(茶筅)」や「KAKASI(案山子)」が和風のネーミングを持っていた流れを意識しつつ、「開発者の好物がめかぶ(和布蕪)であったこと」から名付けられたとされています。
親しみやすい名前に反して、その内部アーキテクチャは極めて洗練された数学的・統計的モデルによって構築されています。
MeCabの内部アルゴリズムと仕組み
MeCabがなぜ「驚異的な高速性」と「高い解析精度」を両立できているのか、その核心は「コスト計算」と「最適経路探索」にあります。
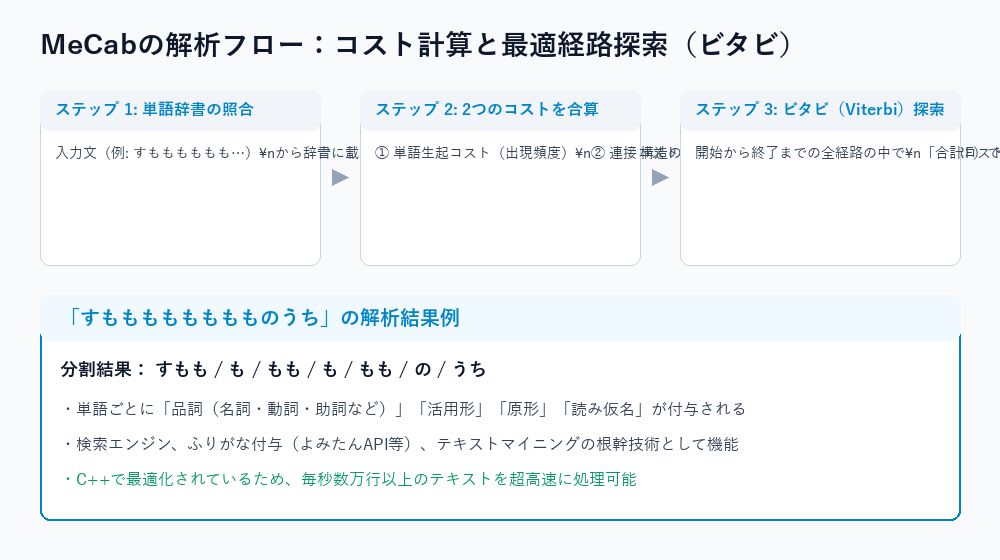
図解:入力文から単語候補の網(ラティス)を構築し、最小コスト経路を算出する流れ
1. 単語候補の網(ラティス構造)の構築
MeCabに入力文が渡されると、まず辞書を参照して、入力文のどこからどこまでが単語になり得るかの候補をすべて洗い出します。
例えば「東京都」という文字列からは、「東京(名詞)」「都(名詞)」という分割候補もあれば、「東京都(固有名詞)」という単一の単語候補も存在します。これら全ての可能性をつなぎ合わせたグラフ構造を「ラティス(Lattice)」と呼びます。
2. 2種類のコスト計算(単語生起コストと連接コスト)
ラティス上には無数の「単語の組み合わせ経路」が存在します。どれが最も自然な日本語の文なのかを判断するために、MeCabは2つの「コスト(ペナルティ値)」を用います。
- 単語生起コスト:その単語自体が日常的にどれくらい使われやすいかを表すコスト。よく使われる一般的な単語ほどコストが低く、めったに使われない単語はコストが高くなります。
- 連接コスト:ある単語(品詞)の直後に、別の単語(品詞)が続く自然さを表すコスト。例えば「名詞の後に助詞が来る」組み合わせは連接コストが低く、「助詞の後に助詞が不自然に連続する」ような組み合わせには高いコストが設定されます。
これらのコストは、条件付き確率場(CRF: Conditional Random Fields)と呼ばれる高度な統計的機械学習モデルを用いて、膨大な正解コーパス(正しく形態素解析された日本語データ)から自動学習されています。
3. ビタビ(Viterbi)アルゴリズムによる最短経路探索
文頭から文末に至る全経路の中で、「累積コスト(単語生起コスト+連接コストの総和)が最も小さくなる経路」が、最も自然で正しい日本語の解釈であると判定されます。
全組み合わせを1つずつ総当たりで計算すると膨大な時間がかかりますが、MeCabは動的計画法の一種である「ビタビアルゴリズム」を採用することで、文末に向かって不要な経路を枝刈りしながら、一瞬で最小コストの経路を導き出します。
用途に合わせて選ぶMeCabの代表的な辞書
MeCabの性能を左右するもう一つの重要な要素が「辞書」です。MeCab本体は汎用的なエンジンであり、背後で読み込む辞書を切り替えることで、解析対象の文章に最適な結果を得ることができます。
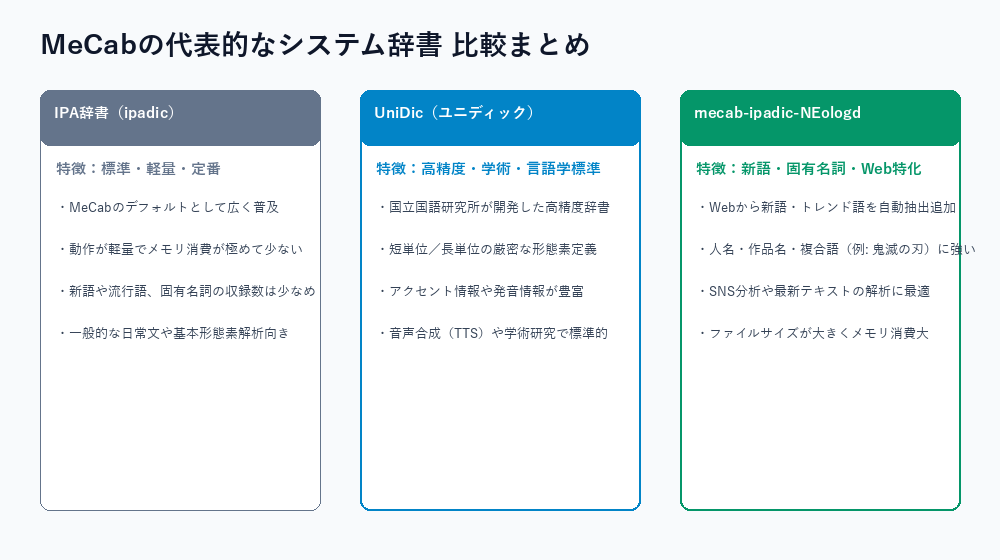
図解:IPA辞書、UniDic、NEologdの各特徴と使い分け
IPA辞書(ipadic):軽量で最も普及している標準辞書
MeCabの初期設定として最も広く使われている定番辞書です。
ファイルサイズが小さく、メモリ消費も極めて軽微であるため、Webサーバー上や軽量なコンテナ環境でも軽快に動作します。
ただし、近年登場した新しい固有名詞や流行語、ネットスラングなどは収録されていないため、現代的なWebテキストの解析では単語が細かく誤分割されてしまうことがあります。
UniDic(ユニディック):国立国語研究所が開発した高精度・学術標準辞書
国立国語研究所が現代日本語の精緻な研究に基づいて作成した辞書です。
単語の区切り基準が「短単位」や「長単位」として厳密に統一されており、アクセント情報や発音情報、歴史的仮名遣いとの対応情報なども保持しています。
学術的な言語学研究、コーパス言語学、音声合成(TTS)エンジンでの読み上げ処理などに最適です。
mecab-ipadic-NEologd:新語・流行語・固有名詞に特化したWeb辞書
Web上の膨大な記事やSNS、Wikipedia、はてなキーワードなどから新語や固有名詞を自動抽出し、定期的に更新されている非常に強力な辞書です。
例えば「鬼滅の刃」を「鬼 / 滅 / の / 刃」とバラバラにせず、「鬼滅の刃(固有名詞)」として1単語で捉えたり、最新のタレント名、企業名、Webサービス名などを正確に認識できます。
SNSのテキストマイニングやトレンド分析には欠かせない辞書ですが、辞書サイズが数百メガバイトに及ぶため、相応のメモリが必要になります。
ユーザー辞書の作成
自社の社内用語、専門用語、製品名、業界独自の略語などをMeCabに正しく認識させたい場合は、「ユーザー辞書」を追加できます。
単語、品詞、読み、コストを記述したシンプルなCSVファイルを作成し、MeCabに付属する「mecab-dict-index」コマンドでコンパイルするだけで、既存の辞書を汚すことなく手軽に解析精度を拡張できます。
Pythonで動かすMeCabの基本コード
MeCabはPythonから非常に簡単に呼び出すことができます。
最も手軽に環境構築できる「mecab-python3」と軽量辞書「unidic-lite」を使った実行例を見てみましょう。
# パッケージのインストール
pip install mecab-python3 unidic-lite
インストール後、以下のPythonスクリプトを実行するだけで形態素解析が行えます。
import MeCab

# タガーオブジェクトの生成
tagger = MeCab.Tagger()

# 解析対象の日本語テキスト
text = "すもももももももものうち"

# 形態素解析の実行
parsed_result = tagger.parse(text)
print(parsed_result)
実行すると、以下のように各形態素ごとの表層形(出現した形)、品詞、品詞細分類、原形、読み仮名などがタブ区切りで出力されます。
すもも	名詞,普通名詞,一般,*,*,*,スモモ,李,すもも,スモモ,和,*,*,*,*
も	助詞,係助詞,*,*,*,*,モ,も,も,モ,和,*,*,*,*
もも	名詞,普通名詞,一般,*,*,*,モモ,桃,もも,モモ,和,*,*,*,*
も	助詞,係助詞,*,*,*,*,モ,も,も,モ,和,*,*,*,*
もも	名詞,普通名詞,一般,*,*,*,モモ,桃,もも,モモ,和,*,*,*,*
の	助詞,格助詞,*,*,*,*,ノ,の,の,ノ,和,*,*,*,*
うち	名詞,普通名詞,副詞可能,*,*,*,ウチ,内,うち,うち,和,*,*,*,*
EOS
末尾の「EOS」は「End of Sentence(文末)」を意味します。
この出力結果から「名詞だけを取り出して頻出単語ランキングを作る」「読み仮名だけを結合してフリガナ列を作る」といった処理が自在に行えます。
LLM時代においてもMeCabが重宝される理由
近年はChatGPTやGeminiなどの大規模言語モデル(LLM)が目覚ましい進化を遂げており、「文章の理解や要約ならLLMに直接投げればよいのでは?」と思われるかもしれません。
しかし、現実のシステム開発や業務現場において、MeCabは依然として揺るぎないポジションを維持しています。それには明確な実務上の理由があります。
- 圧倒的な処理速度:C++で徹底的に最適化されており、1秒間に数万行単位のテキストを解析可能。LLMのようなAPI通信遅延やキュー待ちはゼロです。
- コストが完全ゼロ:自前サーバーやローカルPC上で動作するため、どれだけ大量の文章を解析してもAPI利用料金が発生しません。
- 決定論的で一貫した結果:同じ入力と辞書であれば常に100%同じ分割結果が得られます。データベースのインデックス作成や検索システムにおいて、出力のブレがないことは極めて重要です。
- 検索エンジン(Elasticsearch / Solr)との親和性:全文検索エンジンで日本語を高速にインデックス化する際、形態素解析は標準的なトークナイザーとして基盤を支えています。
例えば、前回の記事でご紹介した「よみたんAPI」のように、「ミリ秒単位で瞬時に正しい読み仮名を返したいWebサービス」や、数百万件の顧客レビューから即座に名詞をカウントしたいバッチ処理などでは、MeCabのような高速な形態素解析器が現在でも最も費用対効果の高い最適な選択肢となります。
まとめ
- 形態素解析は、わかち書きのない日本語を意味のある最小単位に分解し、品詞や読みを特定する自然言語処理の基本技術
- MeCabは先行ツールの課題を克服し、C++による圧倒的な高速性と省メモリを実現したオープンソースエンジン
- 単語生起コストと連接コストを合算し、ビタビアルゴリズムで最小コストの経路を瞬時に導き出す
- IPA辞書(標準)、UniDic(高精度・学術)、NEologd(Web新語特化)などの辞書を使い分けることで真価を発揮する
- LLM全盛の現代でも、超高速・低コスト・確実な再現性を持つテキスト処理基盤として不可欠な存在
普段何気なく利用しているWeb検索やふりがな機能、テキスト分析ツールの裏側では、MeCabのような洗練された形態素解析エンジンが静かに、そして高速に動作しています。
仕組みを深く知ることで、自然言語処理やテキスト活用の幅をさらに広げていきましょう。


