















Googleスプレッドシートで担当者別の月次売上表や生徒別のテスト結果、自治体の地域別・年齢別統計データのように「縦方向に何十行・何百行もデータが並んでいる表」で右端の合計列(横計)を作るとき、数式のコピー作業に手間取ったことはないでしょうか。従来の方法では、一番上の行に =SUM(L2:HE2) のような数式を入力し、最終行までマウスで引っ張って(オートフィルで)複製する必要があります。
そうした各行の横方向集計を、わずか「先頭の1セル」に数式を書くだけで一瞬にして終わらせてくれるのが、モダン関数の「BYROW(バイロウ)関数」です。たとえば =BYROW(L2:HE150, LAMBDA(row, SUM(row))) と1箇所に入力するだけで、何百行にわたる横方向の合計値が下方向のセルへズラリと自動展開(スピル)されます。
本記事では、BYROW関数の基本的な仕組みとLAMBDA関数の読み解き方から、全149小学校区×202列の人口統計オープンデータを使った具体的な横計・データ検算の流れ、さらに平均・件数カウント・空行ガードや行追加への自動追従といった実務レシピ、よくあるエラー対策まで分かりやすく丁寧に解説します。
BYROW関数とは?行ごとに計算して縦方向へ自動展開する仕組み
BYROW関数は、英語の「By Row(行ごとに)」という名前の通り、指定した表(セル範囲・配列)を横の「行単位」で1行ずつ順番に取り出し、それぞれの行に対して指定した計算を行って、結果を「縦1列」に自動展開(スピル)する関数です。
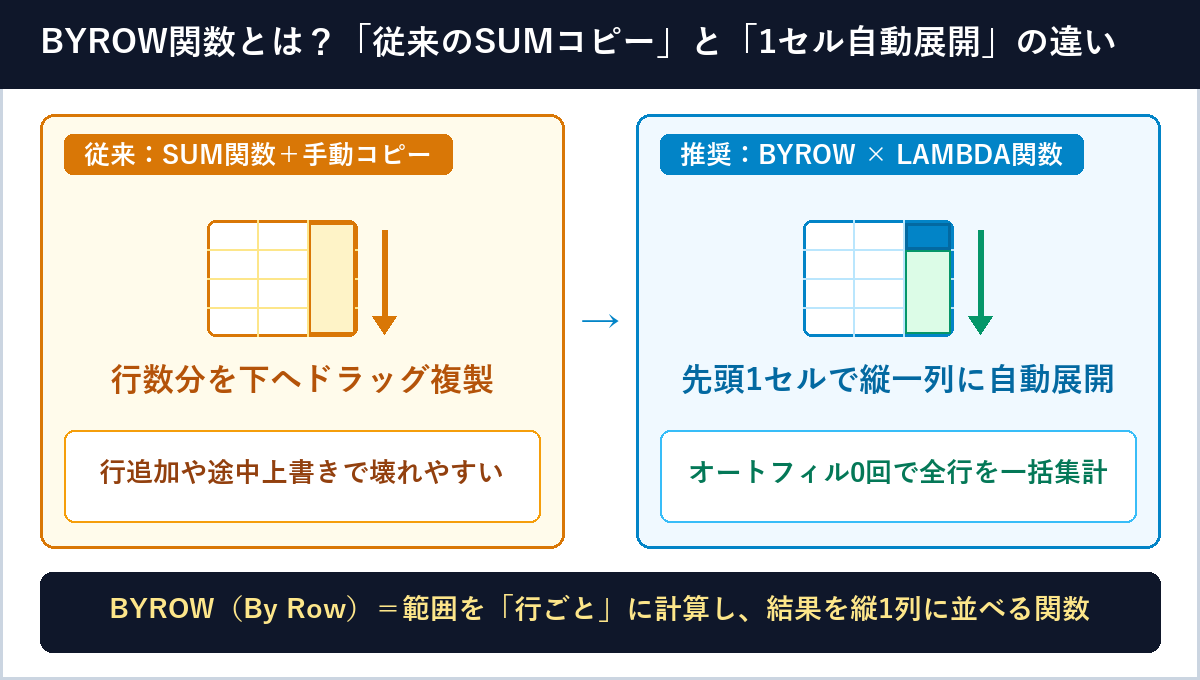
従来のSUM関数+オートフィルで起きやすかった課題
これまでスプレッドシートで各行の横計(右端の合計列)を作る際は、先頭の行(2行目)に =SUM(C2:N2) と入力し、セルの右下にあるフィルハンドルを下方向へドラッグして数式をコピーするのが一般的でした。10行程度の小さな表ならこの方法でも問題ありませんが、行数が100行、500行、1,000行と増えるにつれて次のような課題が発生します。
- 行が増えるたびに数式のコピー漏れが起きる:フォーム回答や日々の売上入力で下に行が追加された際、合計列の数式をオートフィルし忘れると、新しい行だけ集計が抜けてしまいます。
- 途中の行だけ数式が消えても気づきにくい:何百個ものセルそれぞれに個別のSUM関数が入っているため、誰かが誤って途中の1行だけ数値を手入力で上書きしたりDeleteキーで消したりしても、パッと見では発見できません。
- 「ARRAYFORMULA+SUM」では横計が出せない:Googleスプレッドシートで定番の
=ARRAYFORMULA(SUM(C2:N150))を使うと、行ごとの合計ではなく「表全体の総合計(1つの数値)」しか返ってこないため、行単位の集計には使えないという壁がありました。
BYROW関数を使うメリット(作業短縮・メンテナンス性・データ検算)
BYROW関数を取り入れると、数式の実体は「一番上の先頭セル1つだけ」に集約され、2行目以降のセルには計算結果だけが自動的に流し込まれます。実務で特に大きなメリットは次の3点です。
- 何百行・何千行でもオートフィルが一切不要:縦にどれだけ長いリストであっても、先頭の1セルに数式を入力してEnterキーを押すだけで、最終行まで一瞬で横計が完了します。
- 数式の変更や列範囲の拡張が1箇所で完結:「合計(SUM)から平均(AVERAGE)に変えたい」「集計対象の列を増やしたい」というときも、先頭セルの数式を1つ書き換えるだけで全行の計算結果が即座に更新されます。
- オープンデータや統計表の「行単位の検算」に最適:公的統計やCSVデータに記載されている「総数・合計列」と、内訳列(年齢別や月別の内訳)をBYROW関数で横計した結果を突き合わせることで、全行に集計ズレやデータ欠損がないかを一瞬で検証できます。
BYROW関数の基本構文とLAMBDA関数の役割を丁寧に分解
「LAMBDA(ラムダ)関数が組み合わさると急に難しく感じる」という方も多いですが、2つの関数の役割を分けて見ると仕組みは非常にシンプルです。基本構文と各パーツの動きを順番に確認しましょう。
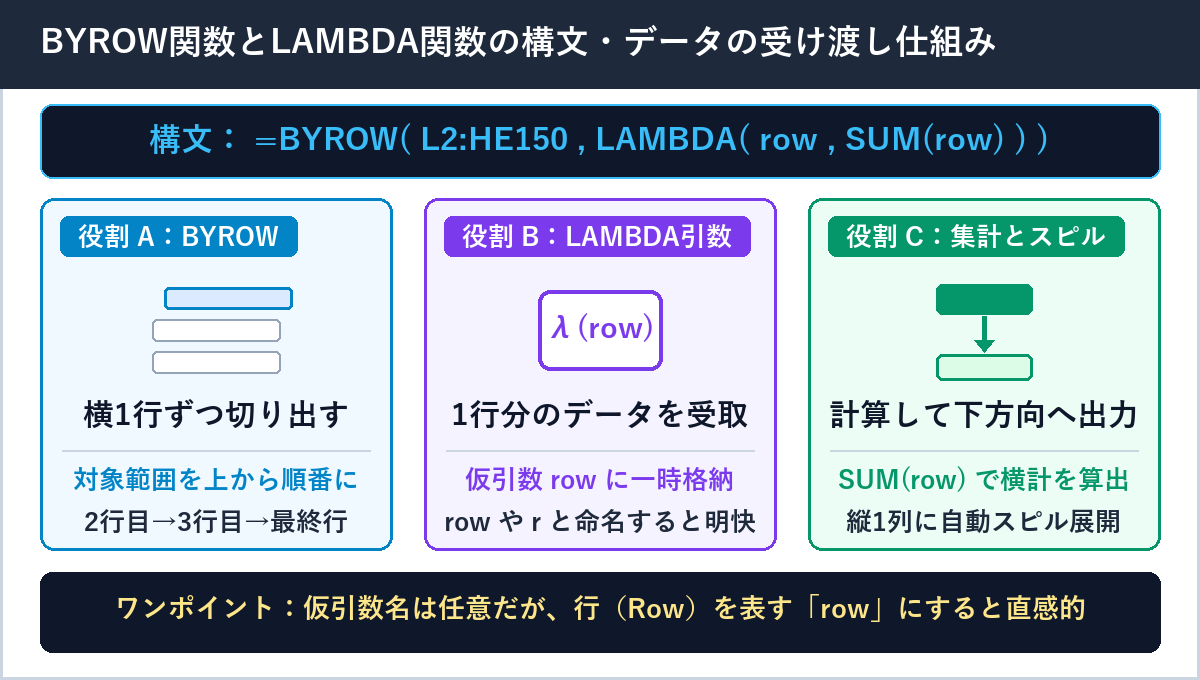
=BYROW(配列または範囲, LAMBDA(引数名, 実行する計算式))

# 実際の記述例(L2:HE150の各行を横方向に合計する場合)
=BYROW(L2:HE150, LAMBDA(row, SUM(row)))
BYROW関数の役割:指定範囲を「行単位」で1行ずつスライスする
外側の BYROW(配列または範囲, LAMBDA関数) は、いわば「表を上から下へ1行ずつ切り分けて手渡す係」です。第1引数に L2:HE150 のようなセル範囲を指定すると、スプレッドシートの内部では次のように上の行から順番に横長の1行データが切り出されます。
- 1回目の処理:
L2:HE2(先頭行の横データ)を切り出してLAMBDAへ渡す - 2回目の処理:
L3:HE3(2行目の横データ)を切り出してLAMBDAへ渡す - 3回目の処理:
L4:HE4(3行目の横データ)を切り出してLAMBDAへ渡す - ……以降、最終行である
L150:HE150(149行目)に到達するまで自動で繰り返す
LAMBDA関数の役割:渡された1行を一時変数で受け取り計算する
第2引数に書く LAMBDA(ラムダ)関数は、「受け取った1行分のデータに対してどんな計算をするか」を指定する計算係です。LAMBDA(row, SUM(row)) のカッコの中は次の2つの要素だけで構成されています。
| LAMBDA内の要素 | 記述例 | 具体的な役割と意味 |
|---|---|---|
| 第1引数(仮引数・変数名) | row |
BYROWから渡された「1行分のデータ」を一時的に入れておく箱の名前(ラベル)です。自分で好きな英単語やアルファベットを付けられます。 |
| 第2引数(実行する計算式) | SUM(row) |
箱(row)に入った1行分のデータを使って実行したい計算です。SUM(row) なら、その行の数値をすべて横方向に合計します。 |
つまり、最初の行で row の中に L2:HE2 が入ると SUM(L2:HE2) が実行され、次の行で row の中身が L3:HE3 に切り替わると SUM(L3:HE3) が実行されてすぐ下のセルに出力される、というサイクルが最終行まで自動で回っています。
変数名についてのワンポイント:任意の名前で動くが「row」が読みやすい理由
LAMBDA関数の第1引数に付ける名前は「数式の中だけで使う一時的なラベル(あだ名)」なので、文法上はどのような名前を付けても正常に動作します。
# 引数名を r や x として書いた場合(計算結果はすべて同じになります)
=BYROW(L2:HE150, LAMBDA(r, SUM(r)))
=BYROW(L2:HE150, LAMBDA(x, SUM(x)))

# 可読性を高めた推奨の書き方(行=row と命名)
=BYROW(L2:HE150, LAMBDA(row, SUM(row)))
ただし、実務でシートを長く運用したりチームメンバーと共有したりする場合は、行(Row)を意味する row または頭文字の r に統一しておくのがおすすめです。列ごとに計算する BYCOL関数では col、行ごとに計算するBYROW関数では row と使い分けることで、数式を一目見ただけで「行と列のどちらを集計しているか」が直感的に伝わります。
【実例解説】オープンデータの全149行を先頭1セルで一括横計・検算する流れ
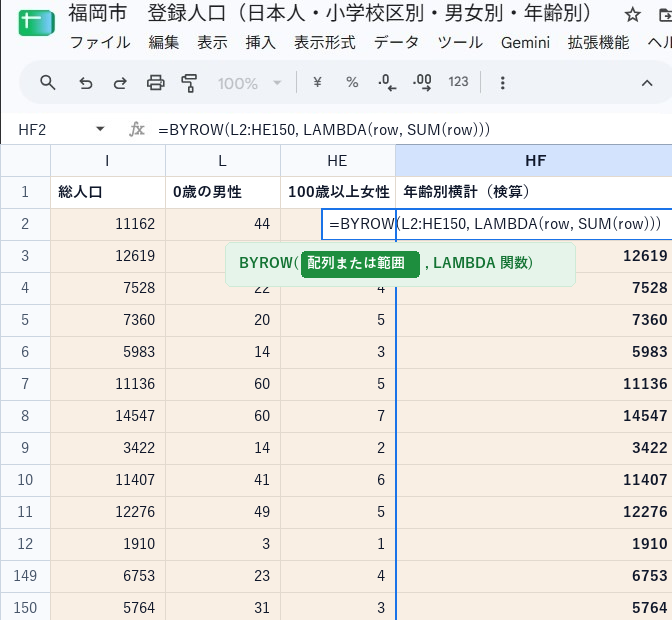
ここからは、実際の公開データを使った具体例でBYROW関数の動きを確認してみましょう。以下は、福岡市のオープンデータ「登録人口(日本人・小学校区別・男女別・年齢別)」をGoogleスプレッドシートに読み込み、右端の HF2 セルにBYROW関数を入力して各小学校区の年齢別人口を横計した画面です。
対象シートのデータ構造(L2:HE150の年齢別202列×全149小学校区)
この人口統計シートは、縦方向に福岡市内の全小学校区(2行目〜150行目の149校区)が並び、横方向には次のような列項目が配置されています。
- H列(H2:H150):各小学校区の「世帯数」
- I列(I2:I150):各小学校区の「総人口」(公式の合計値)
- J列・K列(J2:K150):各小学校区の「男性人口」「女性人口」
- L列〜HE列(L2:HE150):「0歳の男性」「0歳の女性」から「100歳以上の男性」「100歳以上の女性」までの年齢別・男女別人口(全202列)
ここで「各小学校区の0歳〜100歳以上の男女202列(L列〜HE列)を横に足し合わせて、校区ごとの合計人口を右端の HF列 に出したい」という場面を考えます。
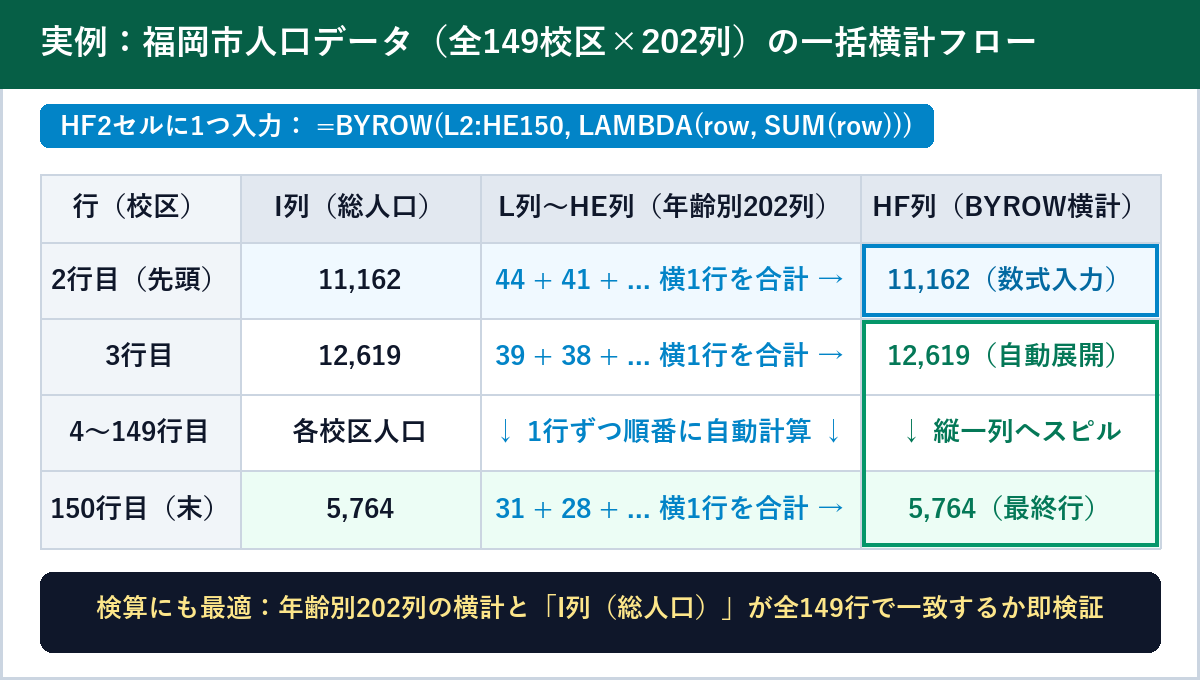
先頭行(2行目)から最終行(150行目)まで順番に計算・展開される過程
右端の先頭セルである HF2 に =BYROW(L2:HE150, LAMBDA(row, SUM(row))) を入力すると、シート上では上から下へ以下の計算が一気に行われます。
- HF2セル(2行目の小学校区の横計):
SUM(L2:HE2)が計算され、0歳から100歳以上までの男女202列を合計した「11,162」が出力されます。 - HF3セル(3行目の小学校区の横計):すぐ下のセルに
SUM(L3:HE3)が自動展開され、「12,619」が出力されます。 - HF4〜HF149セル(各校区の横計):「
7,528」「7,360」「5,983」……と1行ずつ順番に横計結果が並びます。 - HF150セル(最終150行目の横計):最終行の
SUM(L150:HE150)である「5,764」まで出力され、合計「149行 × 縦1列」の集計列が一瞬で完成します。
元データの総人口列と突き合わせる「データ検算」での活用テクニック
オープンデータや業務システムから出力した一覧表では、「内訳列(L列〜HE列の年齢別人口)をすべて足した値」と、最初から印字されている「I列の総人口」が全行で一致しているかを確かめるデータ検算(ベリファイ)が欠かせません。
HF2 セルにBYROW関数を入れて全149行の横計を出したあと、隣の HG2 セルに次のような差分チェック式を1つ置くだけで、149校区すべてで1人のズレもないかを瞬時に確認できます。
# I列(公式の総人口)とHF列(BYROWで算出した年齢別202列の横計)の差分を一括チェックする例
# 全行が 0(または TRUE)になれば、全149行で内訳の欠落・誤差なしと確認できる
=MAP(I2:I150, HF2:HF150, LAMBDA(orig, calc, orig - calc))
実務ですぐ使えるBYROW関数の応用レシピ集
BYROW関数は、LAMBDAの中に記述する関数を SUM 以外に差し替えることで、日常業務のさまざまな「行単位の集計・判定」に活用できます。実務で特に役立つ4つの定番レシピを見ていきましょう。
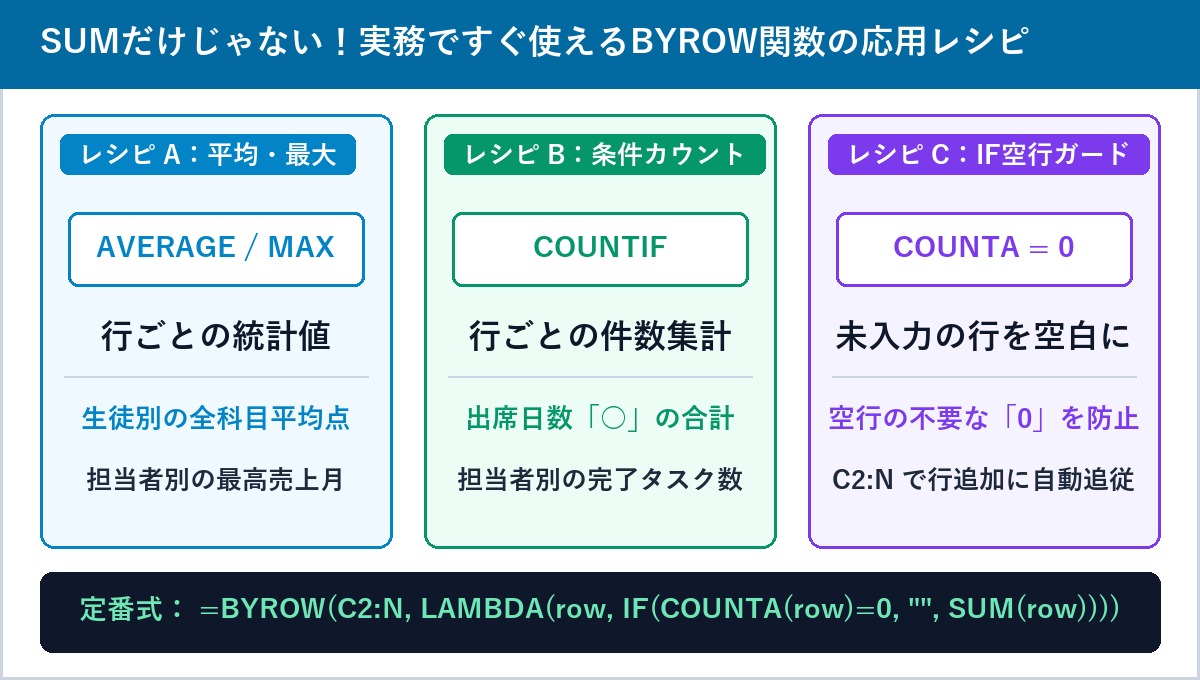
行ごとの平均値(AVERAGE)や最大値(MAX)・最小値(MIN)を求める
生徒別の5教科テスト結果一覧で「生徒ごとの平均点や最高点」を右端の列に出したいときや、店舗別の月次売上表(4月〜3月)で「各店舗の月平均売上や最高売上月」を縦一列に並べたいときは、SUM を AVERAGE や MAX・MIN に置き換えるだけで計算できます。
# 各行(各生徒・各店舗)の平均値を縦一列に出力する(小数第1位で四捨五入する場合)
=BYROW(C2:G100, LAMBDA(row, ROUND(AVERAGE(row), 1)))

# 各行の最大値(個人の最高スコア・店舗の最高月商など)を縦一列に出力する
=BYROW(C2:N100, LAMBDA(row, MAX(row)))

# 各行の最小値を縦一列に出力する
=BYROW(C2:N100, LAMBDA(row, MIN(row)))
出欠表や進捗管理表で行ごとの達成数・回答数(COUNTA・COUNTIF)を数える
社員ごとの研修受講チェック表や、メンバー別の出欠確認表(縦に氏名、横に日付や課題名が並び、「○」や「完了」が入力される表)でもBYROW関数が活躍します。COUNTIF と組み合わせることで、各メンバーの出席日数や完了タスク数を先頭1セルの数式だけで集計できます。
# 各メンバー(各行)で「○」が付いている出席日数を縦一列にカウントする
=BYROW(C2:AG50, LAMBDA(row, COUNTIF(row, "○")))

# 各行で「完了」と入力されているタスク数を一括カウントする
=BYROW(C2:M100, LAMBDA(row, COUNTIF(row, "完了")))

# 各行で空白ではない「入力済みの項目数」を数える
=BYROW(C2:Z100, LAMBDA(row, COUNTA(row)))
未入力の行に「0」やエラーを出さない「IF空行ガード」の書き方
あらかじめ100行分の入力枠を用意しているテンプレート表では、まだデータが入っていない下の方の行に SUM(row) の結果として「0」がズラリと並んでしまったり、AVERAGE(row) で「#DIV/0!」エラーが出てしまったりすることがあります。
これを防ぐには、COUNTA(row)=0(その行にデータが1つも入っていないとき)を判定して空文字 "" を返す「IF空行ガード」を組み込むのが実務の定石です。
# データが1件も入っていない行は空白("")にし、入力がある行だけ横計する
=BYROW(C2:N100, LAMBDA(row, IF(COUNTA(row)=0, "", SUM(row))))

# 未入力行での #DIV/0! エラーを防ぎつつ、入力済みの行だけ平均を出す
=BYROW(C2:N100, LAMBDA(row, IF(COUNTA(row)=0, "", AVERAGE(row))))
行が後から増えても自動で集計対象に含める「オープン範囲(C2:N)」のコツ
先ほどの「IF空行ガード」と組み合わせると非常に便利なのが、範囲の終了行番号を省略する「オープン範囲指定(例:C2:N)」です。このように記述しておくと、今後シートの末尾に何百行データが追加されても、数式を一切書き直すことなく新しい行まで自動的に横計が表示されるようになります。
# 2行目以降のすべての行(C2:N)を対象にし、データが入力された行だけ自動で横計を表示する
=BYROW(C2:N, LAMBDA(row, IF(COUNTA(row)=0, "", SUM(row))))
※この「終了行番号を省略する書き方」を使う際は、シートの一番下に「縦計の合計行」を置かないようにするか、縦計行は表の上部(たとえば1行目を見出し、2行目を縦計行、3行目以降を C3:N で実データ領域)に配置すると、最終行でのデータ衝突(#REF! エラー)を防いで快適に運用できます。
BYROW関数・BYCOL関数・MAP関数の違いと使い分け
GoogleスプレッドシートのLAMBDAヘルパー関数のなかでも、特によく使われる「BYROW」「BYCOL」「MAP」の3つについて、それぞれの違いと選び方を整理しておきましょう。
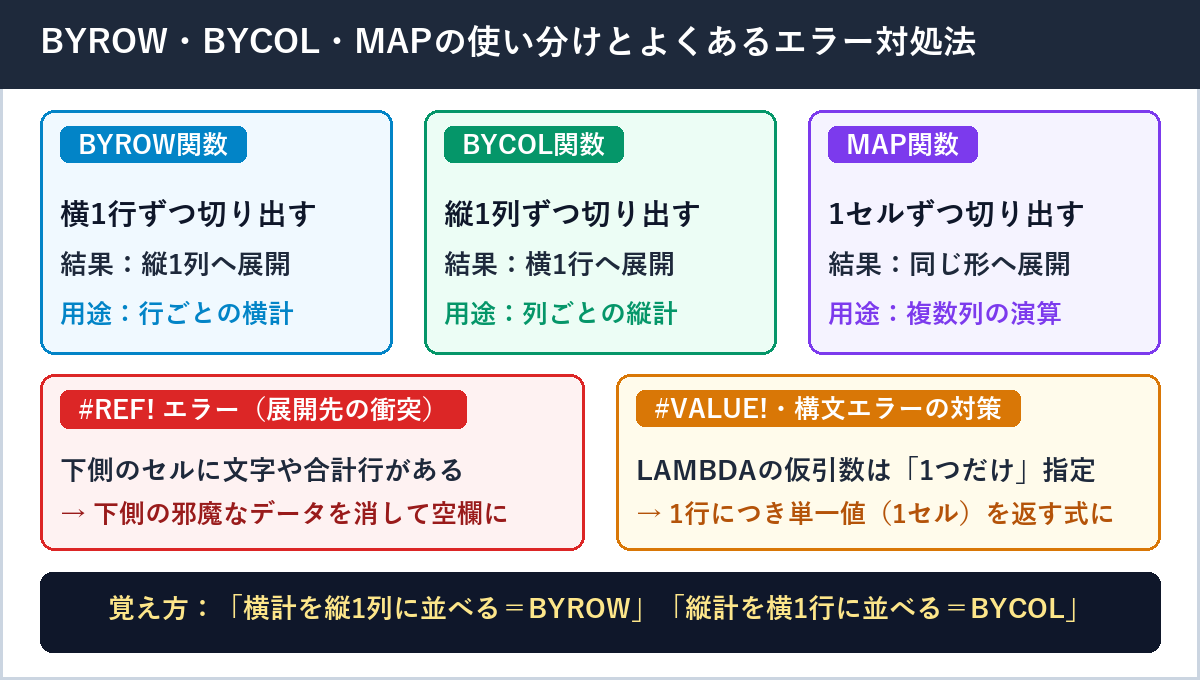
切り出す単位と結果が展開される方向の違い
3つの関数は「元の表をどの単位で切り出してLAMBDAに渡すか」と「結果がどの方向へ並ぶか」が異なります。
| 関数名 | 切り出す単位 | 結果の展開方向 | 適した実務シーン |
|---|---|---|---|
| BYROW関数 | 横の「1行ずつ」 | 縦1列(下方向へ展開) | 担当者別・校区別・生徒別などの「横計」「行平均」「合否判定」を右端の列に並べたいとき |
| BYCOL関数 | 縦の「1列ずつ」 | 横1行(右方向へ展開) | 項目別・月別・年齢別などの「縦計」「列平均」を表の上下に並べたいとき |
| MAP関数 | 個別の「1セルずつ」 | 元の範囲と同じ行数×列数 | 各セルの文字加工や、「単価列×数量列」のように複数列を1行ずつ掛け合わせたいとき |
列ごとの縦計を横1行に自動展開したい場合は「BYCOL関数の構文とLAMBDAの仕組み・200列超の一括集計実例」、セル単位の個別処理や複数列の掛け算を行いたい場合は「MAP関数の使い方とARRAYFORMULAとの違い解説」もあわせて参考にしてみてください。
BYROW関数でよくあるエラーの原因と対処法
最後に、BYROW関数を使った際によく遭遇する3つのエラー原因と、その具体的な解決方法を確認しておきましょう。
「#REF!」エラー(配列結果は展開されませんでした)が出る場合
原因:BYROW関数を入力したセルの「下側(展開先の範囲)」に、すでに手入力の文字や数値、古いSUM関数、あるいは表の末尾の合計行などが1つでも存在していると、既存データを保護するために #REF! エラーとなります。
対処法:先頭セル(数式を入れたセル)より下側のセルをすべて選択してDeleteキーで空欄にしてください。また、C2:N のように終了行を省略しているのに一番下の行に合計行を置いている場合は、C2:N150 のように実データの最終行までを明示的に指定すると即座に解消します。
LAMBDAの引数エラー(仮引数を複数書いてしまっている)
原因:MAP関数では複数の範囲を渡して LAMBDA(a, b, a * b) のように仮引数を複数指定できますが、BYROW関数に渡せる範囲は「1つだけ」であり、LAMBDAで受け取る仮引数も「必ず1つだけ(例:row のみ)」というルールになっています。
対処法:=BYROW(範囲, LAMBDA(row, 計算式)) の形になっているか、また末尾の閉じカッコ )) が2つ揃っているかをチェックしてください。
「#VALUE!」エラー(LAMBDA内で単一の値ではなく配列を返している)
原因:BYROW関数の仕様上、LAMBDAの計算結果は「1行につき単一の値(1セルに収まる1つの数値や文字列)」である必要があります。たとえば LAMBDA(row, SPLIT(row, ",")) や LAMBDA(row, SORT(row)) のように複数列の配列をそのまま返す式を書くと、「各行のLAMBDAの結果は単一の値である必要があります」という #VALUE! エラーが発生します。
対処法:SUM(row)、AVERAGE(row)、MAX(row)、COUNTIF(row, ...)、あるいは1セルの文字列として結合する TEXTJOIN(", ", TRUE, row) など、計算結果が1つの値にまとまる関数を指定しましょう。
まとめ
GoogleスプレッドシートのBYROW関数とLAMBDA関数を組み合わせた行ごとの一括集計方法について、基本構文からオープンデータ149行での横計・検算実例、実務での応用レシピまで解説しました。最後に本記事の大切なポイントを振り返ります。
- BYROW関数の仕組み:指定したセル範囲を「横1行ずつ」順番に切り出してLAMBDA関数へ渡し、行ごとの計算結果を「縦1列」に自動展開(スピル)する関数。
- 基本の書き方と変数名のコツ:
=BYROW(L2:HE150, LAMBDA(row, SUM(row)))のように記述する。仮引数名は行(Row)を表すrowやrにすると直感的で読みやすい。 - 縦長データでの大きなメリット:何百行もある表でもオートフィルが一切不要になり、先頭1セルの修正だけで全行を更新できるほか、総人口列や合計列と照らし合わせる「データ検算」にも威力を発揮する。
- 実務での応用とエラー防止:
AVERAGE・MAX・COUNTIFへの差し替えやIF(COUNTA(row)=0, "", ...)による空行ガードが有効。展開先の下側セルは必ず空欄にして#REF!エラーを防ぐ。
これまで表の右端に横計列を作るたびに最終行までドラッグコピーを繰り返していた方は、ぜひ先頭行のセルに =BYROW(範囲, LAMBDA(row, SUM(row))) を1つ入力してみてください。一瞬で縦一列に計算結果が並ぶ快適さと、行追加や数式修正のしやすさをすぐに実感できるはずです。


