















画像生成AIやディープラーニング(深層学習)の仕組みを学んでいると、生成モデルの基礎として必ず登場するのが「VAE(変分自己符号器:Variational Autoencoder)」と「GAN(敵対的生成ネットワーク:Generative Adversarial Networks)」の2つです。
どちらも「学習データの特徴を捉えて、世の中にまだ存在しない新しい画像やデータを生み出す」という目的は共通していますが、そのアプローチは対照的です。VAEが「データを確率分布(広がりのある範囲)として滑らかな空間に整理する」のに対し、GANは「偽造者(生成器)と鑑定士(識別器)の2つのネットワークを競い合わせる」ことで鮮明なデータを生み出します。
本記事では、VAEの土台である自己符号器との違いや「再パラメータ化トリック」「KLダイバージェンス」の役割から、対になるGANの仕組み、そして両者の得意分野・弱点の比較まで図解とともに分かりやすく解説します。
あわせて読みたい(機械学習の基礎・学習手法の関連記事)
VAEやGANが分類される「教師なし学習(自己教師あり学習)」の基本や、教師あり学習・強化学習・過学習の仕組みについては「機械学習の「教師あり学習・教師なし学習・強化学習」と「過学習」とは?それぞれの仕組みと違いを図解で解説」もあわせてご覧ください。
VAE(変分自己符号器:Variational Autoencoder)とは?
VAE(Variational Autoencoder:変分自己符号器)とは、2013年にDiederik P. Kingma氏とMax Welling氏によって提案された深層生成モデルのひとつです。
その土台になっているのは、入力データを一度小さな情報へ圧縮し、そこから元のデータを復元する「自己符号器(オートエンコーダ:Autoencoder / AE)」というニューラルネットワークです。まずは、土台となる自己符号器とVAEの決定的な違いから見ていきましょう。
土台となる「自己符号器(オートエンコーダ)」の仕組み
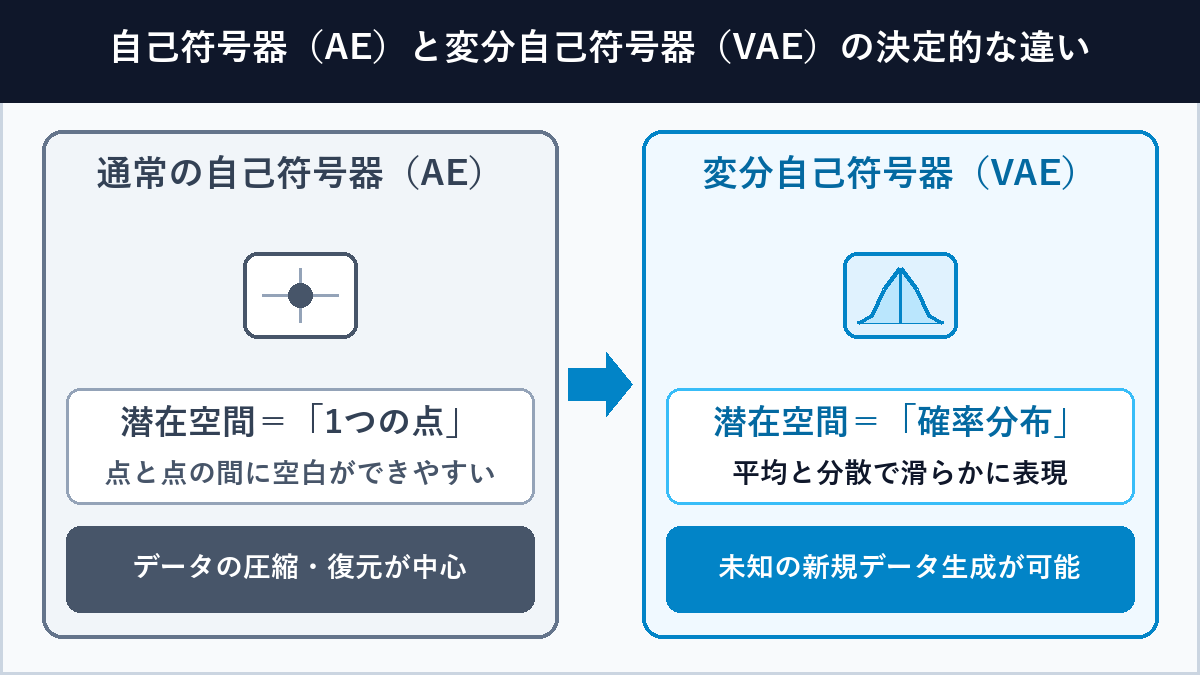
通常の自己符号器(AE)は、高次元の入力データ(たとえば何万ピクセルもある顔画像など)を、一度ギュッと小さな情報である「潜在ベクトル(潜在変数 z)」に圧縮(エンコード)し、そこから元のデータを復元(デコード)するように学習します。
一度狭いボトルネック(潜在空間)を通すことで、ノイズや細かすぎる情報が削ぎ落とされ、データの本質的な特徴(輪郭・向き・表情など)だけが残るのが特徴です。しかし、通常の自己符号器は各データを潜在空間上の「1つの点」としてバラバラに配置してしまうため、点と点の間に「何のデータにも対応しない空白地帯」ができやすく、未知の新しいデータを生成する用途には向いていませんでした。
通常の自己符号器との決定的な違いは「確率分布」で表現すること
VAEが通常の自己符号器と決定的に違うのは、潜在ベクトルを「1つの点」ではなく「確率分布(平均と分散を持つ広がり)」として表現する点です。
たとえば「笑顔の顔画像」を入力したとき、通常の自己符号器は「座標 (2.1, -0.5) という1点」に変換しますが、VAEは「平均は (2.0, -0.5) 付近で、これくらいのばらつき(分散)がある範囲」という正規分布の形で潜在空間にマッピングします。この工夫によって潜在空間の隙間が埋まり、新しいデータの生成が可能になります。
VAEの仕組みと処理の流れ(エンコーダ・サンプリング・デコーダ)
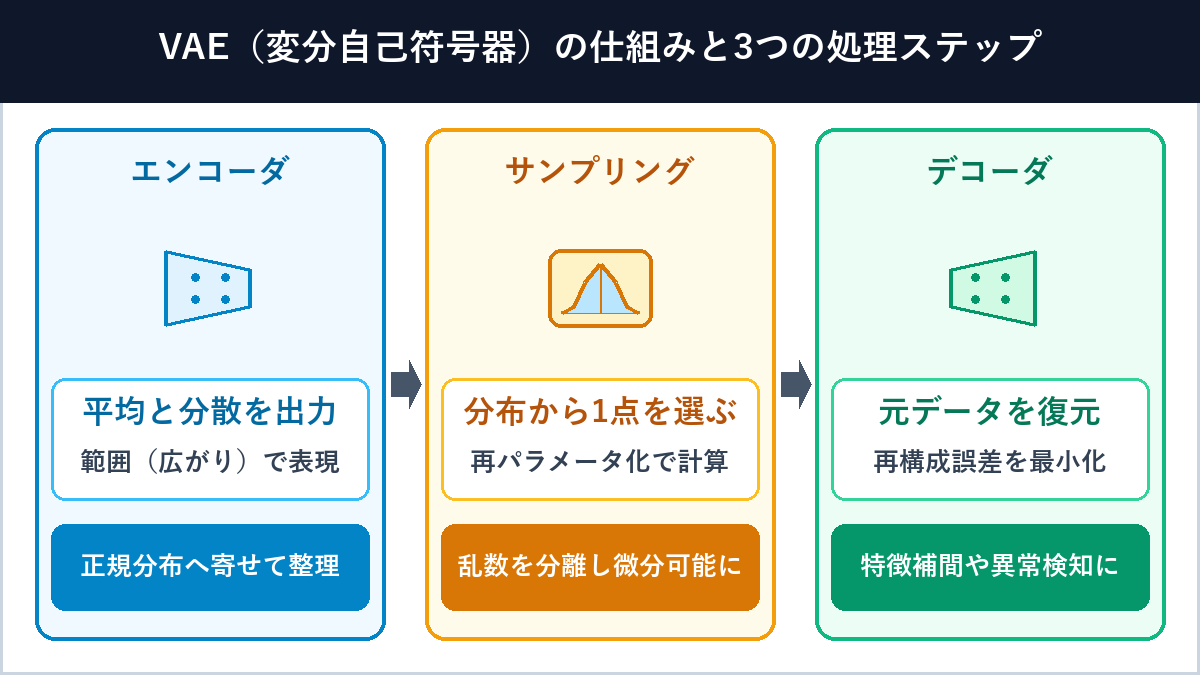
VAEの内部では、データが入力されてから復元・生成されるまでに「エンコーダ」「サンプリング」「デコーダ」という3つのステップが順番に実行されます。
エンコーダ(平均とばらつきの出力)
最初のステップである「エンコーダ(Encoder)」は、入力データ x を受け取り、潜在空間上の確率分布を表す2つのパラメータ、すなわち「平均(μ:ミュー)」と「ばらつき(分散 σ²:シグマ二乗)」を出力します。つまり、「この入力データは、潜在空間上のだいたいこの辺りの範囲に属しています」という分布の設計図を作る役割を担います。
サンプリングと「再パラメータ化トリック」の工夫
次の「サンプリング(Sampling)」では、エンコーダが出力した確率分布(平均 μ、標準偏差 σ)の中からランダムに1点を選び出し、それを潜在ベクトル z とします。
ここで技術的に非常に重要な工夫が「再パラメータ化トリック(Reparameterization Trick)」です。ニューラルネットワークは「誤差逆伝播法(バックプロパゲーション)」という微分の計算によって学習しますが、ネットワークの途中に「サイコロを振るようなランダムなサンプリング処理」が直接入っていると、そこで微分ができなくなり、エンコーダ側へ学習の誤差を伝えられなくなってしまいます。
【そのままでは微分できない表現】
潜在ベクトル z を「平均 μ、分散 σ² の正規分布」から直接ランダム抽出する
→ 確率的な処理がネットワーク内部にあるため、μ や σ について微分できない

【再パラメータ化トリックによる式の変形】
z = μ + σ × ε   (ただし ε は標準正規分布 N(0, 1) から外付けで生成した乱数)
→ 乱数 ε を「外から与える定数入力」として切り離すことで、μ と σ の足し算・掛け算として微分(学習)が可能になる!
このように、ランダム要素(乱数 ε)をネットワークの外側から与える形に数式を変形することで、確率的なサンプリングを行いつつもニューラルネットワーク全体の学習を可能にしています。
デコーダ(潜在ベクトルからの復元・生成)
最後の「デコーダ(Decoder)」は、サンプリングされた潜在ベクトル z を受け取り、元の入力データにできるだけ近いデータ x’ を復元(生成)します。学習が完了した後は、エンコーダを使わずに潜在空間から直接 z を選んでデコーダへ入力するだけで、新しい画像を次々と生成できるようになります。
VAEの学習基準(損失関数)と「滑らかな潜在空間」の意味
VAEがどのように学習を進めるのかを理解する鍵は、学習の基準となる「損失関数(誤差の計算式)」が2つの項目の合計になっていることにあります。
VAEの損失関数 = 再構成誤差 + KLダイバージェンス(正則化項)
- 再構成誤差(Reconstruction Error):デコーダが復元したデータ x’ が、元の入力データ x にどれだけ近いかを測る指標です。この誤差を小さくすることで、元のデータの特徴を損なわずに復元する力が身につきます。
- KLダイバージェンス(Kullback-Leibler Divergence:KL情報量):エンコーダが出力する確率分布(平均 μ、分散 σ²)が、基準となる「標準正規分布(平均0・分散1のきれいな釣鐘型の分布)」からどれだけ離れているかを測る指標です。
なぜ「KLダイバージェンス」で正規分布へ寄せることが重要なのか
もし「再構成誤差」だけを小さくしようとすると、VAEは元の画像を正確に復元することばかりを優先し、ばらつき(分散)をゼロに近づけて、通常の自己符号器と同じように「遠く離れたバラバラの点」として記憶してしまいます。
そこで2つ目の「KLダイバージェンス」を加え、「エンコーダが出す分布を、原点(平均0・分散1)を中心とする標準正規分布にギュッと寄せなさい」という制約(ペナルティ)を同時に課します。これにより、似た特徴を持つデータ同士の分布が少しずつ重なり合いながら原点付近に隙間なく敷き詰められ、潜在空間に「空白地帯」がない連続的で滑らかな空間が作られます。
潜在空間が連続的で滑らかだと何ができるのか?
潜在空間が連続的で滑らかになると、通常の自己符号器では難しかった次の3つの操作が自在に行えるようになります。
- 特徴の段階的な変化(モーフィング):潜在ベクトルを少しずつ動かすと、生成される結果も少しずつ連続的に変化します(例:顔画像において、無表情から笑顔への度合いや、顔の向き・角度・髪の長さなどがなめらかに変わる)。
- 2つのデータの中間生成(補間 / Interpolation):データA(例:メガネをかけた男性)とデータB(例:メガネなしの女性)の潜在ベクトルを足して2で割るなどして混ぜ合わせると、両者の中間の性質を持つ自然なデータが生成できます。
- 未知の新しいデータの生成:空間に空白地帯がないため、標準正規分布からランダムに1点を選んでデコーダに入れるだけで、学習データには存在しない新しいデータを破綻なく生成できます。
VAEの主な用途と弱点(なぜ画像がぼやけやすいのか)
VAEの代表的な3つの用途(特徴学習・データ生成・異常検知)
VAEは単なる画像生成だけでなく、その「確率的に圧縮して復元する」という構造を活かして、実務や研究の幅広い場面で活用されています。
| 主な用途 | 具体的な仕組みと活用シーン |
|---|---|
| 特徴学習・次元削減 | 高次元データ(画像・センサー波形・遺伝子データなど)の本質的な特徴だけを低次元の潜在ベクトルで表現し、データの可視化や後続の機械学習モデルへの入力特徴量として利用する。 |
| 新規データ生成 | 画像・音声・文章・化合物の分子構造など、潜在空間からサンプリングして新しいデータを生成する。近年ではStable Diffusionなどの拡散モデルにおいて画像を潜在空間へ圧縮する部品としても使われている。 |
| 異常検知(Anomaly Detection) | 「正常なデータだけ」をVAEに学習させておく。いざ異常データ(傷のある製品や不正アクセスなど)が入力されると、VAEは正常品のパターンでしか復元できないため、元データとのズレ(復元誤差)が大きくなる。この「復元誤差の大きさ」を指標にして、工場の外観検査や不正検知を行う。 |
VAEの弱点:生成結果が「ぼやけやすい」理由
多くの長所を持つVAEですが、代表的な弱点として「生成される画像がぼやけやすい(輪郭が甘くなりやすい)」という性質があります。
これは、VAEが確率分布からのサンプリングを行いながら「元の画像とピクセル単位で比較して、平均的にどれくらいズレが少ないか(再構成誤差)」を基準に学習するためです。複数の可能性の「無難な平均値」をとるような出力を目指す結果、髪の毛の1本1本や背景の細かいテクスチャといった鋭い輪郭がならされてしまい、少しピンボケしたような滑らかすぎる画像になりやすいのです。この弱点を克服する全く別のアプローチとして登場したのが、次に解説する「GAN(敵対的生成ネットワーク)」です。
GAN(敵対的生成ネットワーク:Generative Adversarial Networks)とは?
GAN(Generative Adversarial Networks:敵対的生成ネットワーク)とは、2014年にIan Goodfellow氏らによって提案された深層生成モデルです。
VAEが「1つのモデルの中で圧縮と復元を行い、元データとの誤差を縮める」のに対し、GANは役割の異なる2つのニューラルネットワークを用意し、お互いに競い合わせる(敵対させる)ことで生成能力を鍛え上げるという画期的な仕組みを採用しています。
「偽造者(生成器)」と「鑑定士(識別器)」のいたちごっこ
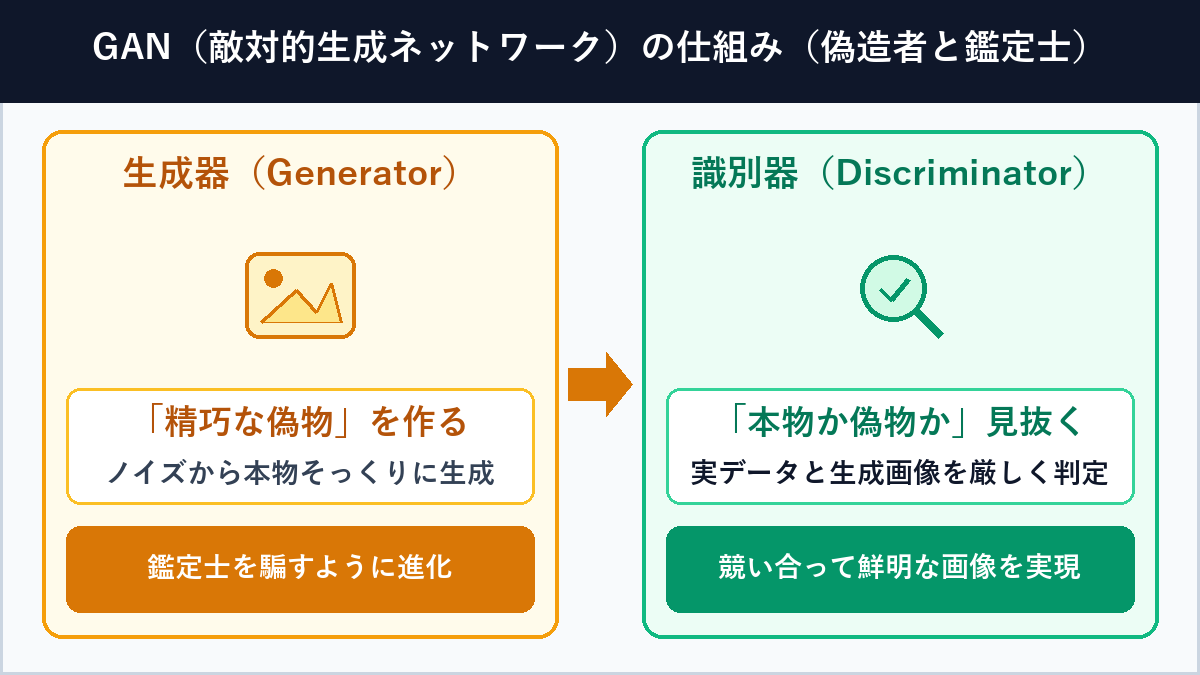
GANの仕組みは、よく「絵画の偽造者」と「絵画の鑑定士(警察)」の対決に例えられます。GANを構成する2つのネットワークの役割を見てみましょう。
- 生成器(Generator:ジェネレータ = 偽造者):ランダムなノイズ(乱数ベクトル)を入力として受け取り、本物の学習データにそっくりな「偽物のデータ(生成画像)」を作り出すネットワークです。目標は「識別器(鑑定士)に『これは本物だ』と誤認させる(騙す)こと」です。
- 識別器(Discriminator:ディスクリミネータ = 鑑定士):渡されたデータが「本物の学習データ(Real)」なのか、それとも「生成器が作った偽物(Fake)」なのかを2値分類で判定するネットワークです。目標は「生成器の作った偽物に騙されず、正確に真贋を見破ること」です。
GANの学習が進むステップと鮮明な画像が作れる理由
学習の初期段階では、生成器はまだ砂嵐のような粗末な画像しか作れないため、識別器は簡単に「これは偽物だ」と見破ります。しかし、以下のサイクルを何万回も交互に繰り返すことで、両者のレベルが飛躍的に高まっていきます。
- 識別器の学習:本物の画像と、生成器が作った偽物の画像の両方を見比べ、「本物を本物、偽物を偽物」と正しく見分けられるように鑑定眼をアップデートします。
- 生成器の学習:自分が作った画像が識別器にどう判定されたかのフィードバックを受け取り、「どうすれば識別器に『本物だ』と判定させられるか」を基準にパラメータをアップデートします。
- 均衡状態への到達:いたちごっこが極限まで進むと、識別器が「本物か偽物か見分けがつかない(確率50%)」という状態に近づき、生成器は人間が見ても本物の写真と区別がつかないほど精巧な画像を出力できるようになります。
GANがVAEと違って輪郭のくっきりした鮮明な画像を生成できる理由もここにあります。VAEのように「元画像との平均的なピクセル誤差」で妥協すると、少しでも画像がぼやけた瞬間に、識別器(鑑定士)から「本物の写真にはそんな不自然なぼやけはない!偽物だ!」と即座に見破られてしまうため、生成器は細部のディテールまで鋭く描くことを強制されるのです。
GANの主な用途と弱点(学習の不安定さとモード崩壊)
GANはその高い描写力を活かして、実在しない人物の顔写真生成(StyleGANなど)、白黒写真のカラー化、低解像度画像の超解像(高画質化)、昼の風景から夜の風景への画風変換(CycleGAN / Pix2Pix)など、高品質な画像生成・画像編集の分野で広く使われています。
一方で、GANにはVAEにはない大きな弱点が2つあります。
- 学習が不安定になりやすい(勾配消失・均衡の崩壊):生成器と識別器のパワーバランスが重要であり、どちらか一方(特に識別器)が賢くなりすぎると、生成器がどう直せばいいか分からなくなり学習が止まってしまうことがあります。
- モード崩壊(Mode Collapse):生成器が「識別器を騙しやすい特定の1パターン(たとえば数字の0〜9を生成すべきなのに『1』の画像ばかり)」を見つけた結果、同じような画像ばかりを繰り返し出力してしまい、生成結果の多様性が失われる現象です。
VAEとGANの違いの比較と使い分けまとめ
ここまで解説してきた「VAE(変分自己符号器)」と「GAN(敵対的生成ネットワーク)」の違いを、図解と一覧表で整理して比較しましょう。資格試験(G検定や生成AIパスポートなど)や実務でのモデル選定でも、まさにこの対比が最も重要なポイントになります。
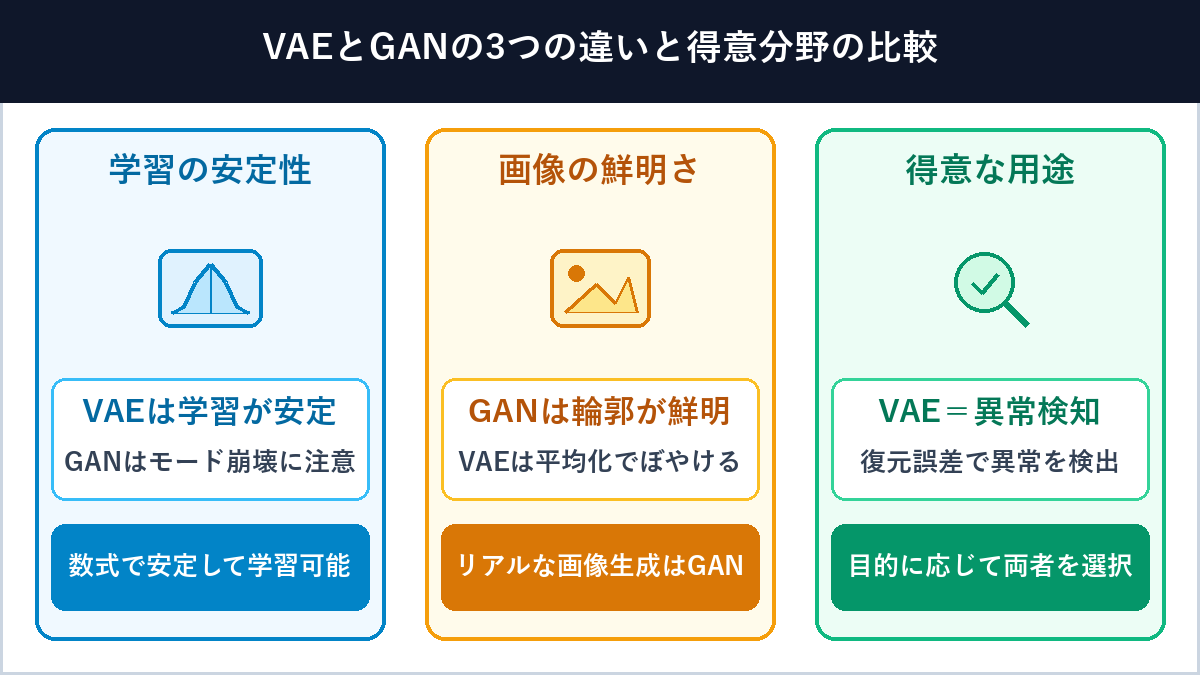
| 比較項目 | VAE(変分自己符号器) | GAN(敵対的生成ネットワーク) |
|---|---|---|
| 基本構造 | エンコーダ + デコーダ (圧縮と復元による確率的モデル) |
生成器(G) + 識別器(D) (偽造者と鑑定士の敵対的学習) |
| 潜在空間の扱い | 入力データを平均・分散の「確率分布」へ明示的に変換できる(特徴抽出が得意) | 乱数ノイズから生成するのみで、既存の入力画像を潜在ベクトルへ逆変換する機能は標準では持たない |
| 学習の基準(損失) | 再構成誤差 + KLダイバージェンス(数式が明確) | 生成器と識別器のミニマックスゲーム(真贋判定の競い合い) |
| 学習の安定性 | 安定している(収束しやすい) | 不安定になりやすい(モード崩壊や勾配消失のリスク) |
| 生成画像の品質 | 平均的な出力を目指すため、輪郭がぼやけやすい | 細部まで本物らしさを追求するため、輪郭がくっきり鮮明 |
| 得意な用途 | 異常検知(工場検査・不正検知)、特徴学習・次元削減、なめらかな補間生成 | 高精細な画像生成、超解像(高画質化)、スタイル変換・画像編集 |
まとめ
深層生成モデルの代表格である「VAE(変分自己符号器)」と「GAN(敵対的生成ネットワーク)」の仕組み・特徴・違いについて解説しました。最後に本記事の要点を整理します。
本記事のポイントまとめ
- VAE(変分自己符号器)の本質:自己符号器(オートエンコーダ)を土台とし、潜在ベクトルを「1つの点」ではなく「確率分布(平均と分散)」として表現する生成モデル。
- VAEの重要キーワード:乱数を外から与えて微分可能にする「再パラメータ化トリック」と、分布を標準正規分布へ寄せて隙間をなくす「KLダイバージェンス」によって、連続的で滑らかな潜在空間を作る。
- VAEの強みと弱点:特徴のなめらかな補間や「復元誤差」を利用した異常検知に強みを持つ一方、平均的に正しい出力を目指すため生成画像がぼやけやすい弱点がある。
- GAN(敵対的生成ネットワーク)との対比:GANは「生成器(偽造者)」と「識別器(鑑定士)」を競い合わせることで、VAEが苦手とするくっきり鮮明な画像生成を実現する(ただし学習の不安定さやモード崩壊に注意が必要)。
VAEの「データを滑らかな潜在空間に圧縮する技術」と、GANの「本物らしさを極限まで高める敵対的学習」は、現在の最新の画像生成AI(拡散モデル / Latent Diffusion Modelsなど)の内部でも重要な基礎パーツとして受け継がれています。両者の仕組みと違いをセットで押さえておくことで、生成AI全体の理解がぐっと深まります。


