















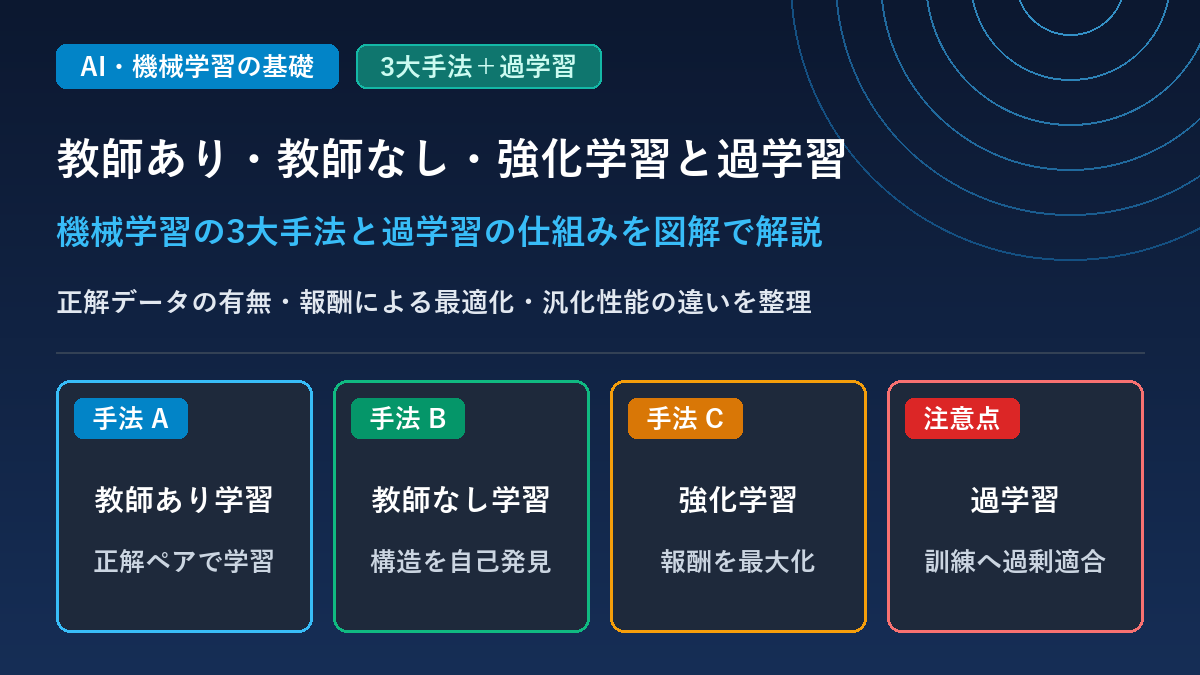
機械学習(Machine Learning)においては、データをどのようにモデルへ学習させるかによって「教師あり学習」「教師なし学習」「強化学習」という3つの学習手法に分類されます。また、モデルの訓練時に注意すべき失敗状態として「過学習(Overfitting)」があります。
たとえば、「入力したデータに対して正解データのペアを与えず、データ自体のパターンや構造をモデルが自己で発見することでトレーニングする手法」は「教師なし学習」に該当します。本記事では、これら4つの項目の定義・数学的/論理的な仕組み・代表的なアルゴリズム・実務での活用例を図解とともに詳しく解説します。
この記事でわかること
- 「教師あり学習・教師なし学習・強化学習」の3大手法と「過学習」の位置づけの違い
- 教師あり学習の仕組み(入力と正解ラベルのペア・回帰と分類の違い)
- 教師なし学習の仕組み(正解ペアを与えずにデータの構造・パターンを自己発見する手法)
- 強化学習の仕組み(エージェントが試行錯誤し、報酬の最大化を目指して行動を学ぶ手法)
- 過学習が起きる原因と、未知データへの汎化性能を高めるための具体的な対策手法
機械学習の3大手法と過学習の全体像(一覧比較表)
まず4つの項目を整理する上で重要なのは、最初の3つ(教師あり学習・教師なし学習・強化学習)が「モデルを訓練するための学習手法(アプローチの種類)」であるのに対し、4つ目の過学習は学習手法ではなく「学習の過程で訓練データに過剰適合してしまった状態(エラー現象)」を指すという点です。
| 項目名 | 分類 | 正解データ(教師)の有無 | 主な目的と仕組み | 代表的なタスク・対策 |
|---|---|---|---|---|
| 教師あり学習 (Supervised Learning) |
学習手法 | あり(入力データと正解ラベルのペアを与える) | 入力から正解を導く関数(規則性)を学習し、未知データの正解を予測する | 売上予測(回帰)、スパム判定・画像識別(分類) |
| 教師なし学習 (Unsupervised Learning) |
学習手法 | なし(入力データのみを与える) | データ自体のパターン・類似性・潜在構造をモデルが自己で発見する | 顧客セグメント分類(クラスタリング)、次元削減、異常検知 |
| 強化学習 (Reinforcement Learning) |
学習手法 | なし(代わりに結果に対する「報酬」を与える) | 環境内で試行錯誤を繰り返し、将来得られる合計報酬が最大になる行動方針(方策)を学習する | 囲碁・将棋AI、ロボット制御、自動運転、生成AIのRLHF |
| 過学習 (Overfitting) |
学習上の問題現象 | ―(主に教師あり学習や深層学習の訓練時に発生) | 訓練データの細かなノイズや例外まで丸暗記してしまい、未知データに対する予測精度(汎化性能)が低下する状態 | 対策:学習データ拡充、正則化(L1/L2)、ドロップアウト、交差検証、早期終了 |
教師あり学習(Supervised Learning)の仕組みと代表タスク
教師あり学習(Supervised Learning)とは、モデルに対して「問題(入力データ X)」と「答え(正解データ/ラベル y)」のペアを大量に与えてトレーニングする手法です。人間が先生(教師)となって正解を教え込むことからこの名称で呼ばれます。
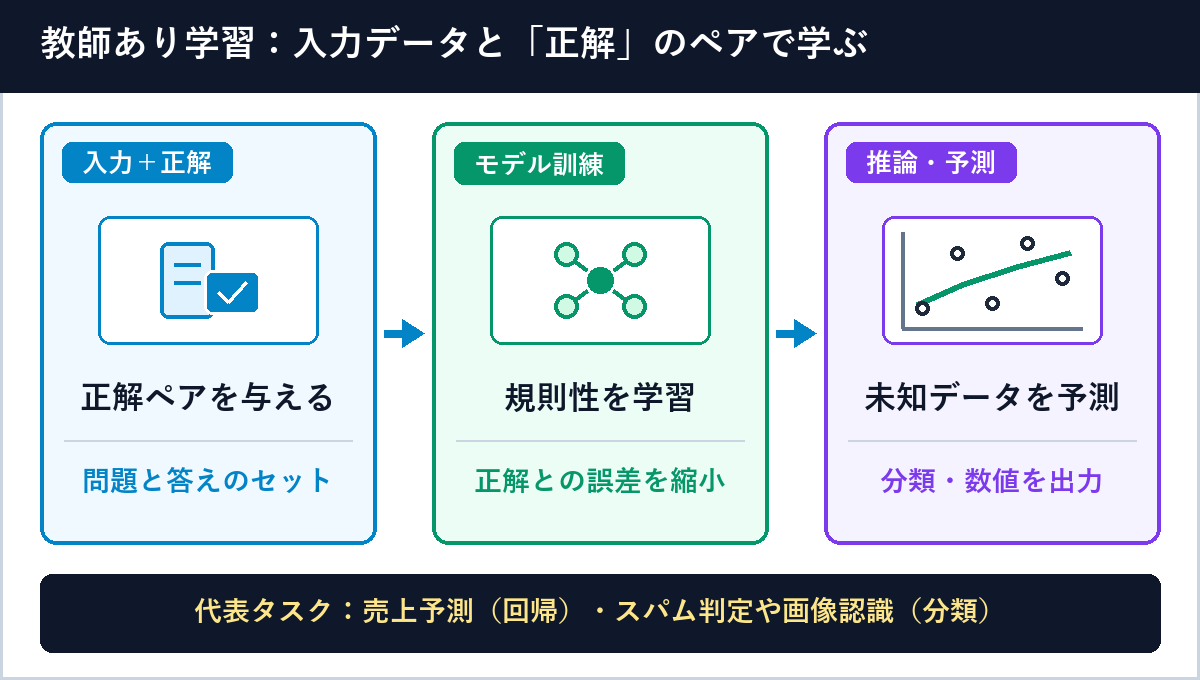
入力データと正解ラベルのペアから規則性を学ぶ仕組み
教師あり学習において、モデルは入力データ X から予測値 f(X) を計算し、あらかじめ与えられた正解データ y とのズレ(損失関数/誤差)を計測します。そして、この誤差が最小になるようにモデル内部のパラメータ(重み)を反復的に調整します。学習が完了すると、まだ正解がわかっていない新しいデータ(未知データ)を入力した際にも、高い精度で正解を予測できるようになります。
代表的な2つのタスク:回帰(Regression)と分類(Classification)
教師あり学習が扱う問題は、予測したい正解データ y の種類によって以下の2つに大別されます。
- 回帰(Regression)― 連続する数値を予測する:
正解データが「気温」「売上金額」「住宅価格」「株価」のような連続値であるタスクです。たとえば、過去の「広さ・駅からの距離・築年数(入力X)」と「実際の成約価格(正解y)」のペアを学習させることで、新規物件の適正価格を数値として算出します。代表的なアルゴリズムには線形回帰、重回帰分析、リッジ回帰、決定木回帰、勾配ブースティング(LightGBM / XGBoost)などがあります。 - 分類(Classification)― カテゴリ(種類)を判定する:
正解データが「スパムメール/通常メール」「犬/猫」「良品/不良品」のような離散的なカテゴリ(クラス)であるタスクです。2つの選択肢から選ぶ問題を「二値分類」、3つ以上のクラス(手書き数字の0〜9の識別など)から選ぶ問題を「多クラス分類」と呼びます。代表的なアルゴリズムにはロジスティック回帰、サポートベクターマシン(SVM)、ランダムフォレスト、ニューラルネットワーク(CNN等)があります。
教師あり学習のメリットと実務上の制約
明確な正解基準を与えて訓練するため、高い予測精度を達成しやすく、精度の評価(正解率・適合率・再現率・平均二乗誤差など)も客観的に行える点が強みです。一方で、学習の前提として「大量の正解ラベル付きデータ(アノテーション済みデータ)」を用意するコストがかかるため、正解が存在しない課題やラベル付けが困難な大量データには次項の「教師なし学習」が用いられます。
教師なし学習(Unsupervised Learning)の仕組みと代表タスク
教師なし学習(Unsupervised Learning)とは、入力したデータに対して正解データのペアを与えず、データ自体のパターンや構造、類似性をモデルが自己で発見することでトレーニングする手法です。
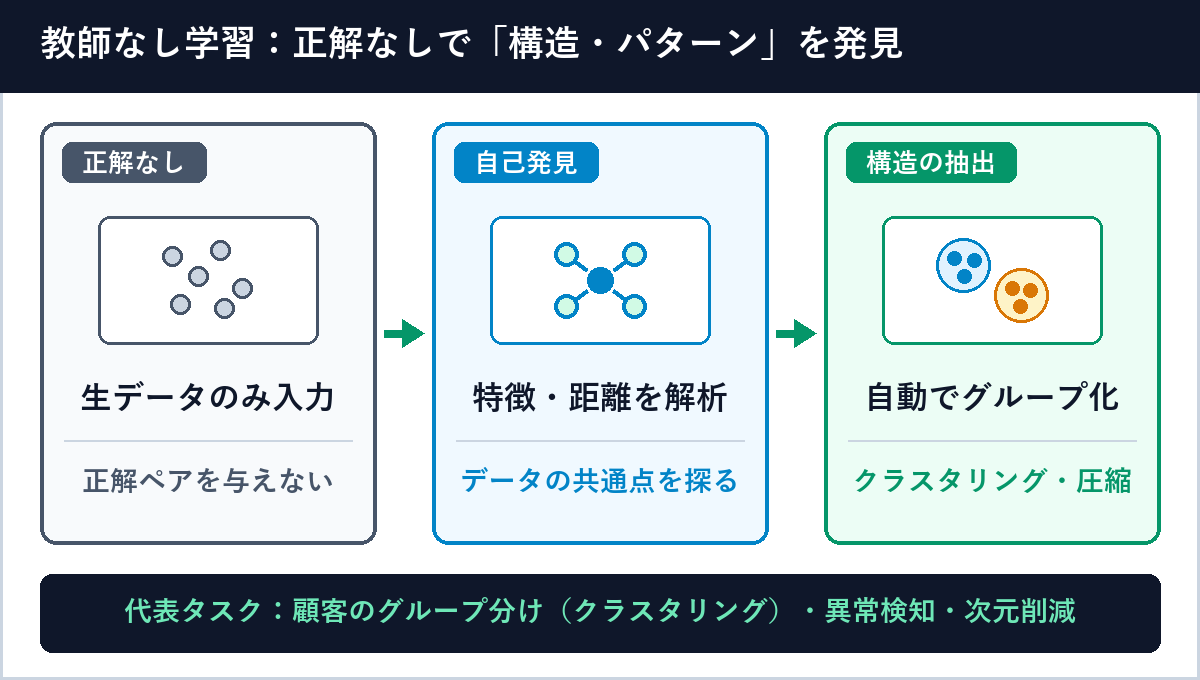
正解データを与えずに構造を自己発見する仕組み
教師なし学習では、「これはAグループである」という事前のお手本(正解ラベル)を一切与えません。モデルは入力された生データの各項目(特徴量)の分布や、データ点同士の数学的な距離(ユークリッド距離やコサイン類似度など)・分散・相関関係を計算し、「どのデータとどのデータが似ているか」「データ全体を最もよく表す軸は何か」という内在的な構造を自動的に抽出します。
代表的なタスク:クラスタリング・次元削減・異常検知
教師なし学習は、データの背後に隠れた法則の発見やデータの前処理・圧縮において以下のタスクで活用されます。
- クラスタリング(Clustering/集団化):
似た特徴を持つデータ同士を自動的に同じグループ(クラスタ)にまとめる手法です。たとえばECサイトの購買履歴データ(購入頻度・購入金額・商品ジャンル)を入力し、正解ラベルなしで「まとめ買い層」「日用品リピート層」「セール時のみ購入層」といった顧客セグメントを自動発見するマーケティング分析に使われます。代表的なアルゴリズムは k-means法(k平均法) や階層型クラスタリング、DBSCANです。
※教師あり学習の「分類(Classification)」はあらかじめ人間が決めた正解クラスに振り分けるのに対し、教師なし学習の「クラスタリング」はグループ分けの基準自体をデータから自動形成する点が異なります。 - 次元削減(Dimensionality Reduction):
数百〜数千個におよぶ多数の項目(高次元データ)から、データの持つ重要な情報(分散)をなるべく損なわずに少数の合成変数へと圧縮する手法です。データの可視化(2次元・3次元グラフへの投影)や、ノイズ除去・計算量の削減に用いられます。代表的なアルゴリズムは 主成分分析(PCA)、t-SNE、UMAP、オートエンコーダ(自己符号化器)です。 - 異常検知(Anomaly Detection)・外れ値検出:
工場のセンサーデータやサーバーの通信ログから「普段の正常なデータの分布パターン」を教師なしで学習し、その分布から大きく外れたデータを「異常(故障予兆や不正アクセス)」として検知する手法です。異常データのサンプルがほとんど存在しないシステム監視で広く利用されます。
強化学習(Reinforcement Learning)の仕組みと代表タスク
強化学習(Reinforcement Learning)とは、最初から固定の正解データを与えるのではなく、システム(エージェント)が環境の中で試行錯誤しながら行動を選択し、その結果として得られる「報酬(Reward:スコア・評価値)」の合計を最大化するように最適な行動ルール(方策:Policy)を学ぶ手法です。
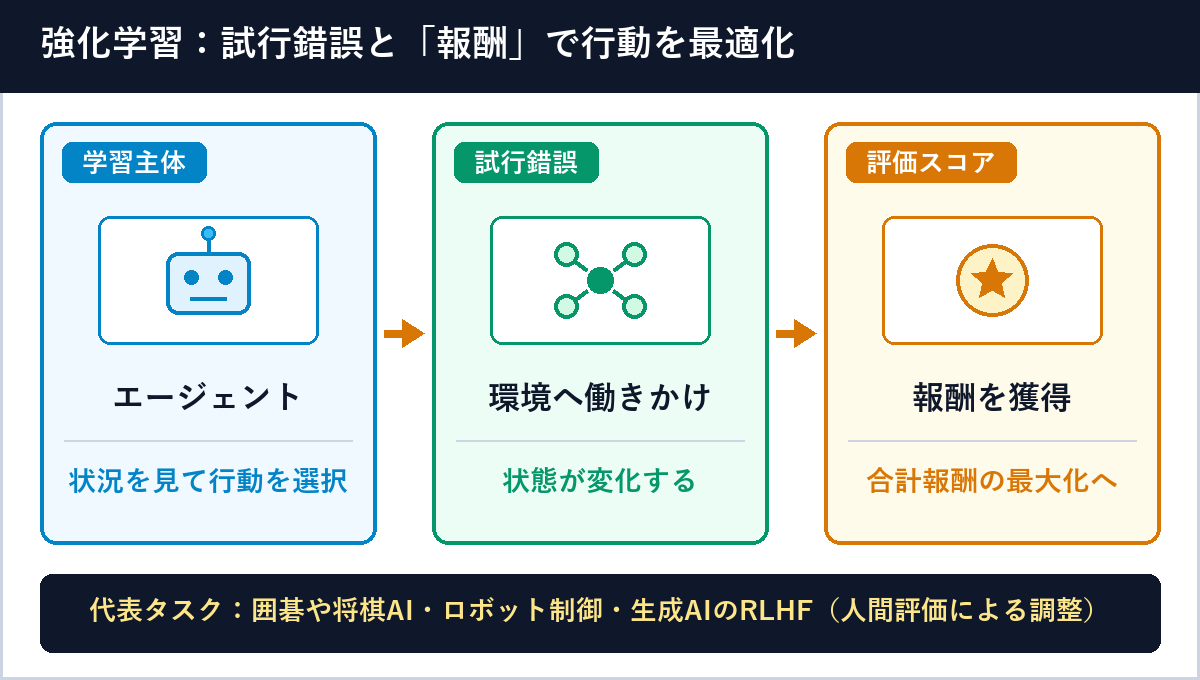
エージェント・環境・状態・行動・報酬の5要素
強化学習のフレームワークは、以下の5つの要素の相互作用(マルコフ決定過程)として定義されます。
- エージェント(Agent):学習し行動を決定する主体(ゲームAIのプレイヤー、制御ロボットなど)
- 環境(Environment):エージェントが置かれている世界やルール(ゲームの盤面、現実の物理空間、シミュレータなど)
- 状態(State):現在の環境の状況(盤面の駒の配置、ロボットの姿勢やセンサー値など)
- 行動(Action):その状態でエージェントが選択できる動作(駒を動かす、モーターを回すなど)
- 報酬(Reward):行動の結果として環境から与えられるプラスまたはマイナスの評価値(ゲームに勝てば+100点、障害物にぶつかれば−50点など)
教師あり学習との違い:長期的な価値の最大化
教師あり学習では「この盤面での正解の1手はこれ」という固定の正解を毎回与えますが、囲碁や将棋、ロボットの歩行、自動運転などでは、目先の1手が本当に最善だったかどうかは最終的な結果(勝敗や目的地への到着)が出るまで確定しません。強化学習では、目先の報酬だけでなく「将来にわたって得られる累積報酬(価値)」が最大になるような一連の行動戦略を、Q学習(Q-Learning)や深層強化学習(DQN・PPOなど)によって自ら獲得します。
大規模言語モデル(生成AI)における強化学習の応用(RLHF)
現代の対話型AI(大規模言語モデル:LLM)の開発では、3つの学習手法が段階的に組み合わされています。
- 事前学習(自己教師あり学習/教師なし学習の発展形):インターネット上の膨大なテキストから「次の単語を予測する」ことで言語の構造や知識を自律的に獲得する
- 教師ありファインチューニング(SFT):人間が作成した「質問と模範回答のペア(正解データ)」を与えて対話形式を学習させる
- 人間のフィードバックによる強化学習(RLHF):AIが出力した複数の回答に対して人間が「どちらが有用で安全か」を採点(報酬を付与)し、その報酬スコアを最大化するように強化学習でモデルの振る舞いを最適化する
過学習(Overfitting)が起きる原因と汎化性能を高める対策
過学習(Overfitting/過剰適合)とは、モデルが訓練用データ(学習データ)に対して過剰に適合しすぎてしまい、訓練データに対する正解率は極めて高いのに、まだ見たことがない未知のデータ(テストデータや本番データ)に対する予測精度が著しく低下してしまう現象です。
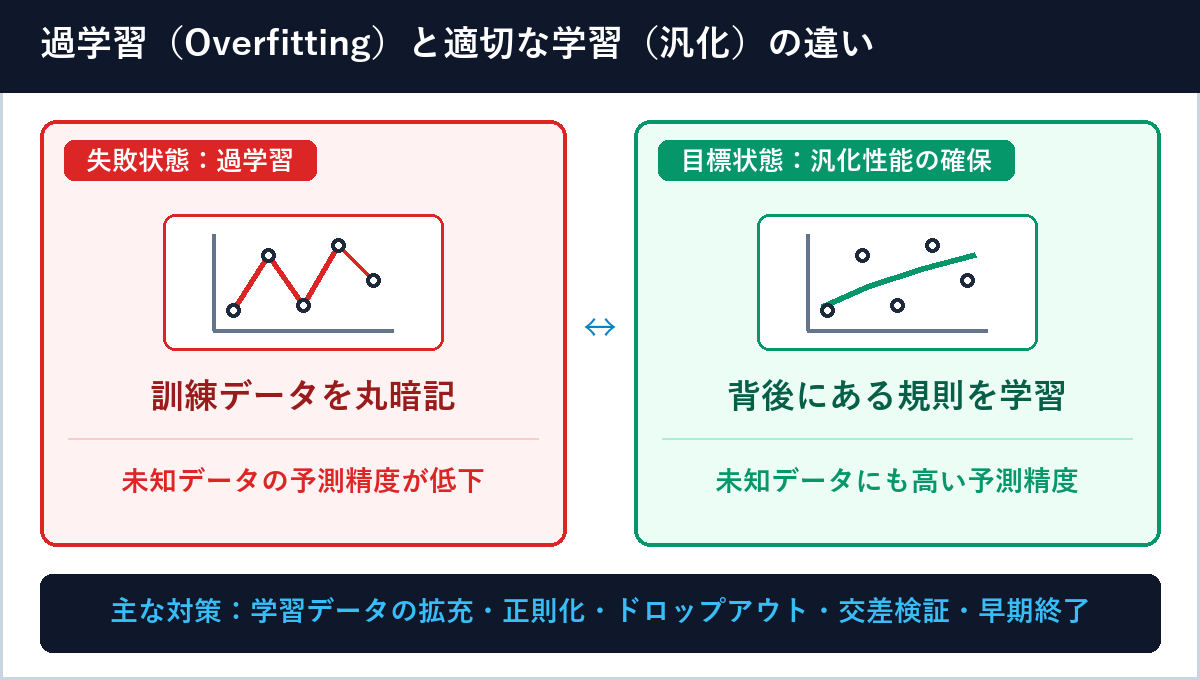
なぜ過学習が起きるのか?「丸暗記」と「汎化性能」
機械学習の本来の目的は、手元の訓練データだけを当てることではなく、将来入力される未知のデータに対しても正しく予測できる能力――すなわち「汎化性能(Generalization Performance)」を獲得することです。
しかし、以下のような条件が重なると、モデルはデータの背後にある本質的な法則ではなく、訓練データに含まれる「偶然の偏り(外れ値やノイズ)」まで忠実に再現する複雑な境界線を引いてしまいます。
- 学習データの件数が少なすぎる、または特定のパターンに偏っている
- データの規模に対してモデルが複雑すぎる(パラメータ数や層が多すぎる、多項式の次数が高すぎる)
- 同じ訓練データに対して過剰な回数(エポック数)の学習を回し続けた
このように訓練データの個別の値や偶発的なノイズだけを記憶してしまい、未知のデータに対して応用が利かなくなる状態が過学習です。なお、逆にモデルが単純すぎて訓練データの特徴すら十分に捉えられていない状態は「未学習(Underfitting/学習不足)」と呼びます。
過学習を検知する方法:ホールドアウト検証と交差検証
過学習を見抜くためには、手元のデータをすべて訓練に使ってしまうのではなく、「訓練データ(Training Data)」と「検証・テストデータ(Validation / Test Data)」に分割して評価します。
- ホールドアウト法(Hold-out):データ全体をたとえば「訓練用80%:テスト用20%」に分割し、訓練に使っていない20%のデータで精度を測定する手法
- 交差検証(Cross Validation / k-分割交差検証):データを
k個のブロック(例:5分割)に分け、「1つを検証用・残りk-1個を訓練用」として入れ替えながらk回学習と評価を行い、平均精度を算出する手法
訓練データの誤差は下がり続けているのに、検証データの誤差が途中から上昇(悪化)し始めた場合、その時点で過学習が発生していると判断できます。
過学習を防ぐ代表的な5つの対策手法
| 対策手法 | 仕組みと効果 |
|---|---|
| 学習データの拡充・データ拡張 (Data Augmentation) |
学習データ数を増やして多様なパターンを学ばせる。画像認識では、既存の画像を回転・反転・切り抜きして人工的にデータを水増しする「データ拡張」が使われる。 |
| 正則化(Regularization) (L1正則化 / L2正則化) |
モデルの損失関数に「パラメータ(重み)が大きくなりすぎることへのペナルティ項」を加算し、曲線が極端に複雑に折れ曲がるのを数学的に抑制する。 |
| ドロップアウト(Dropout) | ニューラルネットワークの学習中、各層のノード(ニューロン)を一定の確率でランダムに無効化して学習させることで、特定の特徴への過度な依存を防ぐ。 |
| 早期終了(Early Stopping) | 学習エポックを進める中で、検証データ(Validation)に対する誤差が改善しなくなった(悪化し始めた)時点で自動的にトレーニングを打ち切る。 |
| 特徴量選択・モデルの簡素化 | 不要な説明変数(ノイズとなる特徴量)を削減したり、決定木の深さ(max_depth)を制限してモデルの自由度を適切な範囲に抑える。 |
Python(scikit-learn)で見る各概念のコード例
Pythonの機械学習ライブラリ scikit-learn を使うと、「教師あり学習」「教師なし学習」「過学習の検証」がコード上でどのように異なるかを明確に比較できます。
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.cluster import KMeans
from sklearn.datasets import load_iris

# サンプルデータ(アヤメの花の特徴量 X と、品種の正解ラベル y)の読み込み
X, y = load_iris(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# ---------------------------------------------------------
# 1. 教師あり学習:入力データ X_train と正解ラベル y_train のペアを渡す
# ---------------------------------------------------------
# max_depth=3 で木の深さを制限し、過学習を抑制したモデル
clf_good = DecisionTreeClassifier(max_depth=3, random_state=42)
clf_good.fit(X_train, y_train)  # X と y のペアで訓練
print("適切なモデル - 訓練精度:", clf_good.score(X_train, y_train))
print("適切なモデル - 未知テスト精度:", clf_good.score(X_test, y_test))

# ---------------------------------------------------------
# 2. 過学習の例:深さ制限なしで訓練データを丸暗記させた場合
# ---------------------------------------------------------
clf_overfit = DecisionTreeClassifier(max_depth=None, random_state=42)
clf_overfit.fit(X_train, y_train)
# 訓練データでは 1.0(100%)になるが、複雑なデータでは未知テスト精度が低下する
print("制限なしモデル - 訓練精度:", clf_overfit.score(X_train, y_train))
print("制限なしモデル - 未知テスト精度:", clf_overfit.score(X_test, y_test))

# ---------------------------------------------------------
# 3. 教師なし学習:正解ラベル y を一切渡さず、データ X だけでクラスタリング
# ---------------------------------------------------------
kmeans = KMeans(n_clusters=3, random_state=42, n_init="auto")
kmeans.fit(X)  # 正解ラベル y を与えず X のみで構造(3グループ)を自己発見
print("教師なし学習で自動発見されたグループ番号:", kmeans.labels_[:10])
上記のコードの通り、教師あり学習では fit(X_train, y_train) のように入力と正解のペアを渡すのに対し、教師なし学習(KMeans)では fit(X) のように正解データを与えずにデータ X のみから構造を抽出します。
まとめ:機械学習の4つの基本概念の整理
今回解説した機械学習の4つの項目(教師あり学習・教師なし学習・強化学習・過学習)の要点を整理します。
本記事の要点まとめ
- 教師あり学習:入力データと「正解データ」のペアを与えて規則性を学ばせる手法。数値予測の「回帰」とカテゴリ判定の「分類」に大別される
- 教師なし学習:正解データのペアを与えず、データ自体のパターンや構造をモデルが自己で発見する手法。「クラスタリング(k-means法など)」「次元削減(PCAなど)」「異常検知」に使われる
- 強化学習:正解データの代わりに、エージェントの行動結果に対する「報酬(スコア)」を与え、累積報酬が最大になる行動戦略を試行錯誤で獲得させる手法
- 過学習(Overfitting):学習手法ではなく、訓練データのノイズまで過剰に適合(丸暗記)してしまい未知データへの汎化性能が失われた状態。データ拡充・正則化・ドロップアウト・早期終了・交差検証で対策する


