















パーソナルAIアシスタント「Muse」をはじめ、ChatGPT・Claude・Geminiなどの対話型AIには、ユーザーとの過去のやり取りから職業・使用ツール・文章の好み・進行中のプロジェクトを記憶する「メモリ(Memory)機能」が備わっています。そして、1つのAIアシスタントに蓄積された記憶を別のAIアシスタントへ引き継ぐ際に用いられるのが、Museのメモリインポート機能などで採用されている「コンテキスト移行(ポータブルな記憶のスナップショット作成)プロンプト」です。
このプロンプトを普段利用しているAIに入力すると、過去の会話履歴から確実な事実のみを抽出し、移行先のAIのメモリシステムへそのまま登録できる構造化Markdownを1つのブロックとして生成できます。本記事では、このプロンプトに含まれる7つの出力ルールと10の抽出セクションの設計意図、そのままコピーして使える整形済みプロンプト(日本語版・英語版)、および具体的な移行手順を図解とともに解説します。
この記事でわかること
- Museのコンテキスト移行プロンプト(Portable Memory Snapshot)の目的と仕組み
- メモリの品質を保ち誤認識を防ぐ「7つの出力ルール」の設計意図
- ユーザーのプロフィールと文脈を整理する「10の抽出セクション」の役割一覧
- コピペでそのまま使える整形済みプロンプト全文(日本語版・英語原文)と出力サンプル
- 既存のAIから新しいAIへ安全に記憶を引き継ぐ3つの手順とプライバシー管理の注意点
Museのコンテキスト移行プロンプトとは?記憶をスナップショット化する仕組み
AIアシスタントを日常の業務や開発、執筆に長く利用するほど、AI側には「どのような立場で働いているか」「どのプログラミング言語やOSを使っているか」「どのような文体やフォーマットを好むか」といった前提情報(コンテキスト)が蓄積されていきます。しかし、新しいAIサービス(Museなど)を使い始める際や複数のAIを併用する際には、新しい環境側にこれらの前提知識が存在しないため、最初から自己紹介や出力ルールの指定をやり直す手間が生じます。
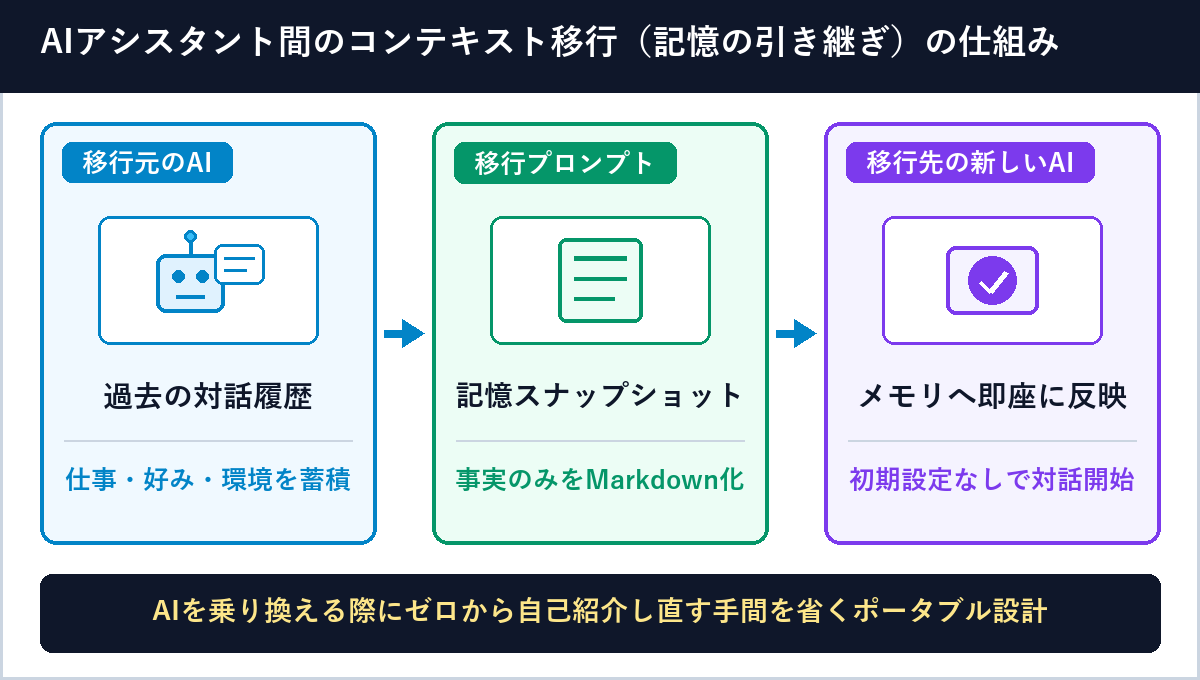
Museのコンテキスト移行プロンプトは、移行元のAIに対して「過去の会話からユーザーについて確実に知っていることだけを、移植可能な記憶のスナップショット(Portable Memory Snapshot)としてコンパイルする」よう指示するプロンプトです。チャットログを丸ごとコピーするのではなく、新しいAIのメモリシステムへそのまま転送できる純度の高い事実リスト(Markdown形式)に変換する点が特徴です。
そのまま使える整形済みプロンプト全文(日本語版・英語版)
まずは実際にAIへ入力して使えるプロンプト全文を掲載します。1行につながったテキストのまま送信するよりも、見出し(##)や箇条書き(-)ごとに改行を入れた状態で送信する方が、AI側がMarkdownの構造を正確に認識できます。
日本語版の整形済みプロンプト(コピー用)
あなたは、1つのAIアシスタントから別のAIアシスタントへのコンテキストの移行を手伝っています。あなたの仕事は、過去の会話から、私についてあなたが確実に知っていることを、移植可能な記憶のスナップショットとしてコンパイルすることです。出力は新しいAIのメモリーシステムにそのまま転送されるため、すべてを書き出すこと(情報の量)よりも品質(確実性)が重要です。

出力ルール
- 以下のセクションヘッダーを使用して、Markdownブロックを1つ出力してください。確実な情報がないセクションは省略してください。プレースホルダーは使用しないでください。
- 各項目内で、私を指す際は三人称(「ユーザー」、「彼ら」)を使用してください。
- 1項目につき、事実を1文で記述してください。その項目以外のつなぎ、説明文、注記は一切入れないでください。
- 自信がない項目は、項目の最後に「(推測)」と記載してください。
- 重要であることが明確でない限り、単発の発言はスキップしてください。
- 機密情報(健康状態、金銭情報、精神衛生)については、明確に記憶するよう私が依頼しない限りスキップしてください。
- ハード上限: 2000語。

セクション
## ID
名前、代名詞、年齢層、現在の居住地/国、タイムゾーン、使用言語。

## 職業・役職
会社員または自営業、業界、チームまたは部門、主な職務。技術スタックおよび日常的に使用するツール(分かっている場合)。

## コミュニケーションの好み
トーン(カジュアル/フォーマル、率直/温かい)。望ましい回答の長さ。出力フォーマットの好み(Markdown、プレーンテキスト、コードブロック)。避けるよう依頼されたもの。

## 定期的に登場する人
パートナー、子供、親しい家族、友人、話題にする同僚。名前+関係+特記事項。

## 健康と食生活
アレルギー、食事制限、アクセシビリティの要件。自分で述べたことのみ含めるようにしてください。

## 興味・趣味
繰り返し話題に上がるテーマ。スポーツ、音楽、ゲーム、読書の好み。

## 進行中のプロジェクト
あなたが協力を依頼された現在進行中の個人的または仕事上のプロジェクト。状態、目標、制約。

## 作業スタイルおよび価値観
意思決定の仕方、モチベーションの源泉、不満を感じる点。明確に「これをしてほしい」「これはやめてほしい」と頼んできたこと。

## ツールと環境
定期的に使用するデバイス、オペレーティングシステム、アプリ、サービス、言語、フレームワーク。

## その他の永続情報
上記に該当しない重要な事柄で、来年も変更されない可能性が高いもの。
英語原文のプロンプト(英語でのメモリ抽出にも対応)
移行先のAIが英語ベースのメモリシステムを採用している場合や、トークン消費を抑えて高密度に抽出させたい場合は、以下の英語原文プロンプトをそのまま使用できます(日本語で出力させたい場合は末尾に Output in Japanese. と1行追加します)。
You are helping me migrate context from one AI assistant to another. Your job is to compile, from our past conversations, a portable memory snapshot of what you reliably know about me. The output is going verbatim into a new AI's memory, so quality matters more than completeness.

OUTPUT RULES.
- Output a single Markdown block using the section headers below. Omit any section you have nothing solid for — do not invent placeholders.
- Refer to me in the third person ("the user", "they") inside each bullet.
- One factual sentence per bullet. No transitions, no narrative.
- Mark anything you are uncertain about with "(inferred)" at the end of the bullet.
- Skip one-off statements unless they were clearly important.
- Skip sensitive information (health conditions, financial details, mental health) unless I explicitly asked you to remember it.
- Hard cap: 2000 words.

SECTIONS.
## Identity.
Name, pronouns, age range, current city / country, time zone, languages spoken.

## Profession & work.
Role, company or self-employed, industry, team or function, key responsibilities. Tech stack and tools used daily if known.

## Communication preferences.
Tone they want (casual / formal, blunt / warm). Preferred response length. Output format preferences (Markdown, plain text, code blocks). Things they have asked you to avoid.

## Recurring people.
Partner, children, close family, friends, colleagues they mention regularly. First name + relationship + any salient detail.

## Health & dietary.
Allergies, dietary restrictions, accessibility needs. Only include things they have stated themselves.

## Interests & recurring topics.
Topics they keep returning to. Sports, music, games, reading taste.

## Current projects.
Active personal or professional projects they have asked you to help with. State, goal, constraints.

## Working style & values.
How they make decisions, what motivates them, what frustrates them. Explicit "always do X" or "never do Y" requests they have made.

## Tools & environment.
Devices, operating systems, apps, services, languages, frameworks they use regularly.

## Other durable facts.
Anything else important that does not fit above and is likely to still be true a year from now.
プロンプト前半の解説:メモリ品質を高める「7つの出力ルール」
このプロンプトの優れている点は、単に「私について知っていることをまとめて」と頼むのではなく、出力がそのまま別のAIのシステムメモリに組み込まれることを前提とした厳密な制約(Output Rules)を課している点にあります。
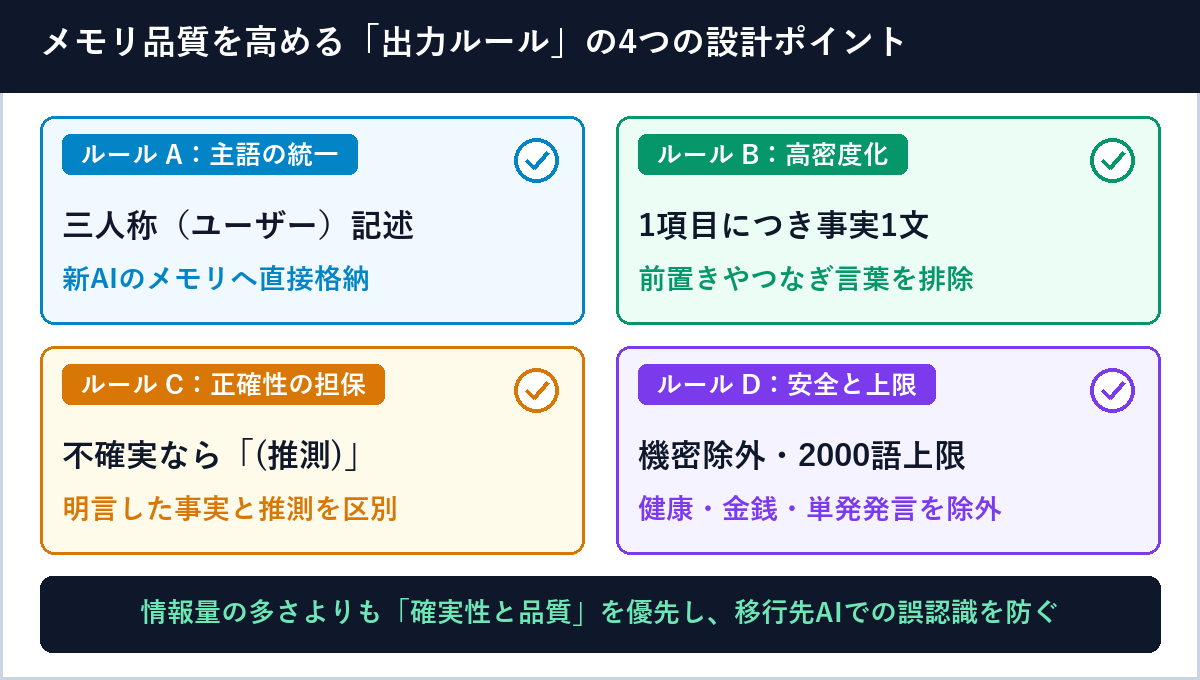
| 出力ルールの指示内容 | プロンプト設計上の目的と効果 |
|---|---|
| 単一のMarkdownブロック出力と空セクションの省略 (プレースホルダー不使用) |
情報がない項目に「不明」「特になし」といったダミー文字列(プレースホルダー)が出力されるのを防ぎ、移行先AIのメモリ領域に無駄なテキストが登録されるのを防止します。 |
| 三人称(「ユーザー」「彼ら」)での統一記述 | AIの内部メモリやシステムプロンプトは「ユーザーは〜である(The user is…)」という三人称の客観形式で管理されます。一人称(「私は〜」)や二人称(「あなたは〜」)を避けることで、移行先AIが主語を混同せずにそのまま記憶として読み込めます。 |
| 1項目につき事実を1文で記述 (つなぎ・説明文・注記の排除) |
「これまでの会話を振り返ると〜」といった物語調の表現(ナラティブ)や挨拶文を削ぎ落とし、1つの箇条書きに1つの事実だけを格納することで、検索性とトークン効率を高めます。 |
| 不確実な項目への「(推測)」ラベル付与 | AIが文脈から勝手に推測した事柄が、移行先のAIで「確定した事実」として固定化される(ハルシネーションの連鎖)のを防ぎます。人間がインポート前に目視で削除・修正する際の目印にもなります。 |
| 単発の発言をスキップ | 1回だけ調べたエラーや一時的な質問など、長期的なパーソナライズに不要なノイズを除外し、繰り返し登場する本質的な情報だけを残します。 |
| 機密情報(健康・金銭・精神衛生)のスキップ | 過去の相談履歴に含まれるセンシティブな個人情報が、意図せず別サービスのメモリへ流出・保存されるリスクを抑制します。 |
| ハード上限:2000語 | 各AIサービスのメモリ保存上限やコンテキストウィンドウを圧迫しないよう最大語数を制限し、重要度の高い情報だけを厳選させます。 |
プロンプト後半の解説:プロフィールを構造化する「10の抽出セクション」
プロンプトの後半では、AIが過去の対話履歴を走査する際の「観点」として10個のセクション見出し(##)を定義しています。これにより、抽象的な人物像ではなく実務や日常対話に直結する具体的な属性が漏れなく整理されます。
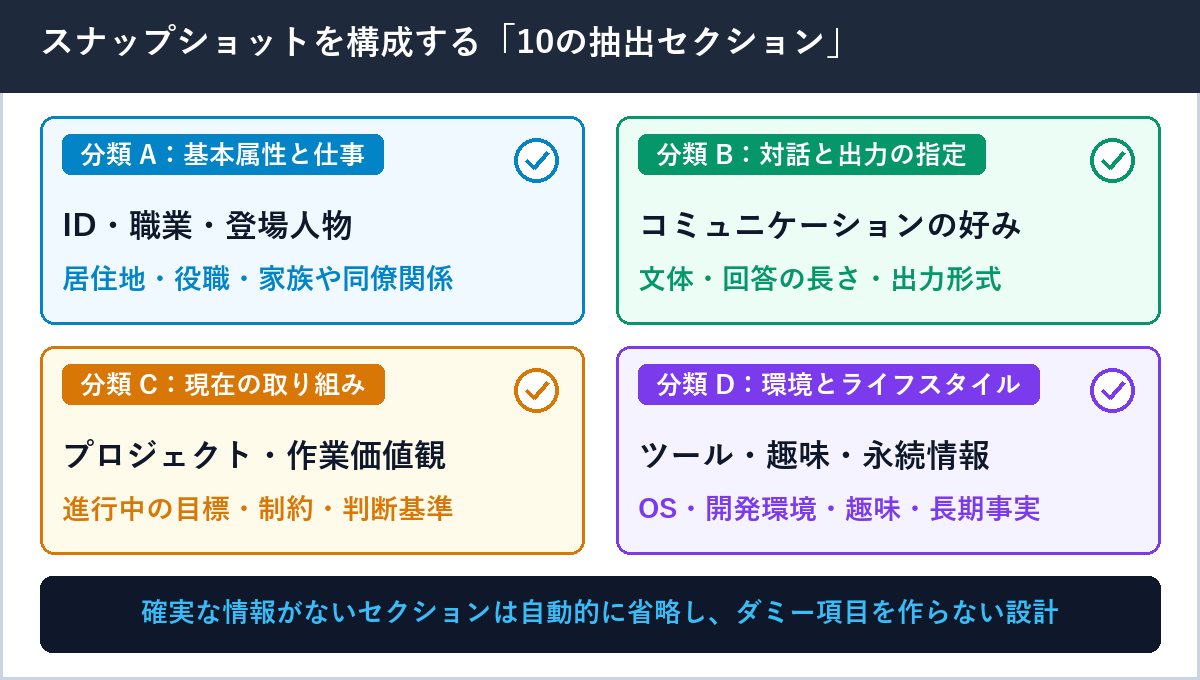
| セクション見出し | 抽出される主な内容 | 移行後のAI対話で役立つ場面 |
|---|---|---|
| ID (Identity) |
名前、代名詞、年齢層、居住地/国、タイムゾーン、使用言語 | 地域の制度・通貨・時刻に合わせた回答や使用言語の自動選択 |
| 職業・役職 (Profession & work) |
会社員/自営業、業界、部門、主な職務、日常使う技術スタック | 専門用語のレベル調整(初心者向け説明の省略)や実務に即した提案 |
| コミュニケーションの好み (Communication preferences) |
文体トーン、望ましい回答の長さ、出力形式、避けるよう依頼した表現 | 初回チャットから好みのフォーマットや文体で回答を得る |
| 定期的に登場する人 (Recurring people) |
パートナー、家族、友人、同僚の名前と関係性・特記事項 | スケジュール相談やメール作成時に人物関係を説明し直す手間の削減 |
| 健康と食生活 (Health & dietary) |
本人が明言したアレルギー、食事制限、アクセシビリティ要件 | レシピ提案や飲食店選び、UI設計相談時の配慮 |
| 興味・趣味 (Interests & recurring topics) |
繰り返し話題に上がるテーマ、スポーツ、音楽、ゲーム、読書傾向 | アイデア出しや例え話、情報収集時の関心領域とのマッチング |
| 進行中のプロジェクト (Current projects) |
現在進行中の個人・業務プロジェクトの状態、目標、制約条件 | 進行中の開発や執筆タスクの前提条件をそのまま引き継いで作業再開 |
| 作業スタイルおよび価値観 (Working style & values) |
意思決定基準、不満を感じる点、「必ず〜する/〜はしない」という明示ルール | 過去に何度も訂正したAIの癖(不要な前置きや誇張表現など)の再発防止 |
| ツールと環境 (Tools & environment) |
使用デバイス、OS、エディタ、クラウドサービス、開発言語、フレームワーク | OS固有のコマンド(Windows / Mac)や使用言語に合ったコードの即時出力 |
| その他の永続情報 (Other durable facts) |
上記9項目に当てはまらない重要な事実で、1年後も変わらない可能性が高い情報 | 長期的な目標や保有資格・運営メディアなどの前提共有 |
特に実務上で効果を発揮するのが「コミュニケーションの好み」と「作業スタイルおよび価値観」の2セクションです。これまでの対話の中でAIに対して「見出しに数字を付けないでほしい」「推測表現を使わないでほしい」「コードは省略せず全文書いてほしい」と指示してきた履歴が抽出されるため、新しいAIでも最初から自分好みの出力ルールを適用できます。
コンテキスト移行プロンプトの具体的な使い方(3ステップ)
実際に既存のAIからMuseや別のAIアシスタントへ記憶を引き継ぐ手順は以下の3ステップです。
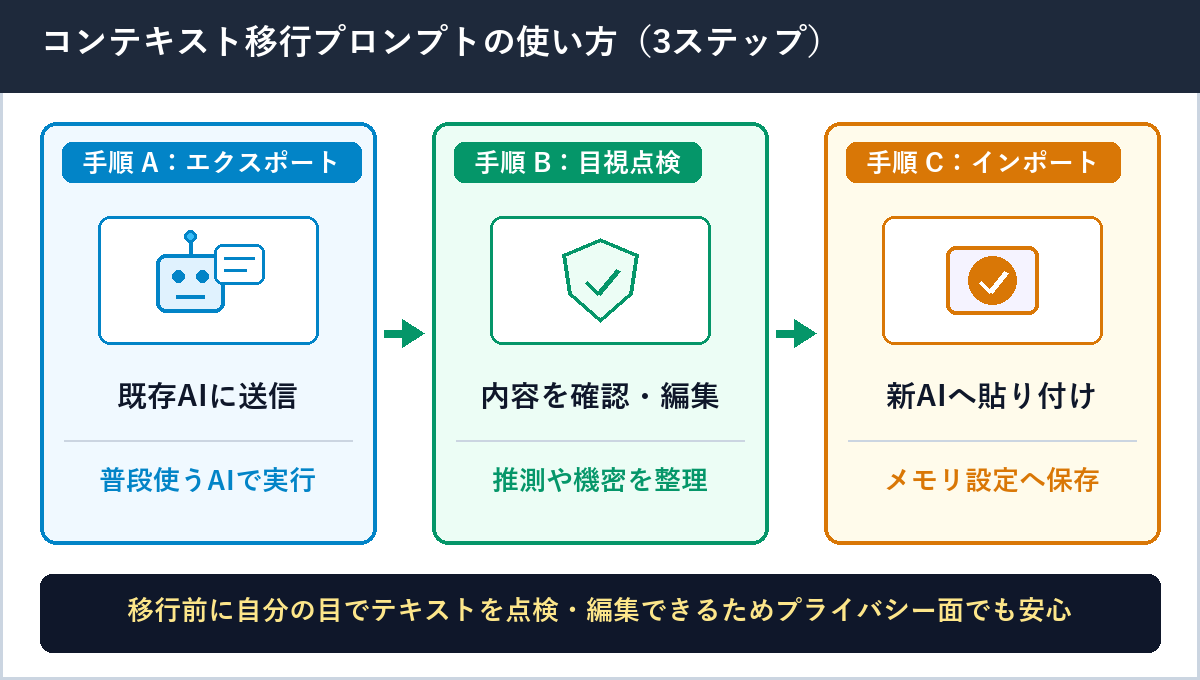
手順A:普段使っている移行元AIでプロンプトを実行する(エクスポート)
これまで最も長く対話してきたAI(ChatGPT、Claude、Geminiなど)で新しいチャットを開き、メモリ機能(過去のチャット履歴の参照機能)が有効になっていることを確認した上で、上記のプロンプト全文を貼り付けて送信します。
実行すると、以下のようなMarkdown形式のスナップショットが出力されます。
## ID
- ユーザーは日本在住で、タイムゾーンはJST(UTC+9)を使用している。
- ユーザーはすべての対話とドキュメント作成において日本語を使用する。

## 職業・役職
- ユーザーはWebメディアの運営およびシステム開発を行っており、技術解説記事の執筆と自動化ツールの構築を担当している。

## コミュニケーションの好み
- ユーザーは誇張表現を排したフラットで事実ベースの説明スタイルを好む。
- ユーザーは記事の見出し(h1〜h6)の先頭に数字や連番を付けない形式を指定している。
- ユーザーはマークダウンの太字記号(アスタリスク2つ)を使用しない出力を求めている。

## 進行中のプロジェクト
- ユーザーはWordPressサイト「eguchi.net」の運用およびPythonスクリプトによる記事・図解画像の自動生成パイプラインを構築している。

## 作業スタイルおよび価値観
- ユーザーは事実確認ができない推測表現や頻度表現を使用せず、確認可能な仕様と論理的な仕組みのみを記述することを重視している。
- ユーザーはWordPressの記事投稿において「1記事につき単一カテゴリーのみを設定する」というルールを厳守している。

## ツールと環境
- ユーザーは日常的にWindows環境とPowerShellを使用している。
- ユーザーはPython(Pillow、requests、Playwright)およびWordPress REST API、Google Apps Script(GAS)を使用している。
手順B:出力されたMarkdownを目視で確認・編集する
出力されたMarkdownブロックをコピーし、メモ帳やテキストエディタに貼り付けて内容を確認します。この段階で以下の3点をチェックして手直しを行うと、移行先での精度がさらに向上します。
- 「(推測)」または「(inferred)」が付いた項目の確認:事実として正しい場合は末尾の「(推測)」という文字を消し、誤っている場合や不要な場合はその行ごと削除します。
- すでに終了した古いプロジェクトの整理:過去に相談したものの現在は完了しているタスクが含まれている場合は削除するか、現在の状態に書き換えます。
- 個人情報の最終チェック:移行先のサービスに保存したくない固有の社名や人名が含まれていないかを確認します。
手順C:移行先の新しいAIに読み込ませる(インポート)
確認・編集を終えたMarkdownテキストを、移行先のAIアシスタントに登録します。主なAIサービスごとの登録先は以下の通りです。
| 移行先のAIサービス | スナップショットの登録・インポート方法 |
|---|---|
| Muse | メモリ設定(Memory Import / Active Memory)のインポート欄に、出力されたMarkdownブロックをそのまま貼り付けて保存します。 |
| Claude | 「設定(Settings)> プロフィール(Profile)」の個人設定欄、または「Projects」機能の「Project Instructions(プロジェクト指示)」やナレッジファイルとして貼り付けます。 |
| ChatGPT | 「設定 > パーソナライズ > カスタム指示(Custom Instructions)」に貼り付けるか、チャット欄で「以下のユーザー情報をメモリに記憶してください」と添えて送信します。 |
| Gemini | 「設定 > 保存された情報(Saved info)」に項目を登録するか、Gem(カスタムAI)の指示文(Instructions)にMarkdownを貼り付けて保存します。 |
運用時のポイント:定期的なスナップショット更新とバックアップ活用
このコンテキスト移行プロンプトは、別のAIへ乗り換えるときだけでなく、「現在メインで使っているAIが自分をどのように認識しているかの棚卸し(メモリ監査)」としても活用できます。
- AI側の誤解を発見して修正できる:プロンプトを実行してみると、半年前に一度だけ試したツールを「現在もメインで使用している」とAIが誤認しているケースなどが可視化されます。不要な記憶をリセットし、整理したスナップショットを再登録することで回答の精度を保てます。
- モデル非依存のプロフィール控えになる:生成されたMarkdownファイルを自分のPCやノートアプリ(ObsidianやNotionなど)に1つ保存しておけば、今後新しいAIエージェントやローカルLLMを試す際にも、そのファイルを読み込ませるだけで即座に自分専用の環境を構築できます。
まとめ:Museの移行プロンプトでAI間の記憶をスマートに引き継ごう
Museのコンテキスト移行プロンプトの構造と出力ルール、およびAIアシスタント間での具体的な引き継ぎ手順を解説しました。
本記事の要点まとめ
- プロンプトの役割:既存のAIとの過去の対話履歴から確実な事実だけを抽出し、別のAIのメモリにそのまま登録できるMarkdownスナップショットを生成する
- 7つの出力ルール:三人称(「ユーザー」)での記述、1項目1文の事実記述、不確実な項目への「(推測)」付与、単発発言や機密情報の除外、2000語上限によって高品質なメモリを作る
- 10の抽出セクション:ID、職業、コミュニケーションの好み、登場人物、健康と食生活、興味・趣味、進行中プロジェクト、作業スタイル・価値観、ツール・環境、永続情報を体系的に整理する
- 安全な3ステップ移行:既存AIで出力(エクスポート)したあと、人間が目視で「(推測)」箇所や不要項目を編集してから新しいAIへ登録(インポート)する
新しいAIアシスタントを導入する際や、複数のAIの前提知識を揃えたい際は、ぜひ上記のプロンプトを使って自分専用の記憶スナップショットを作成してみてください。


