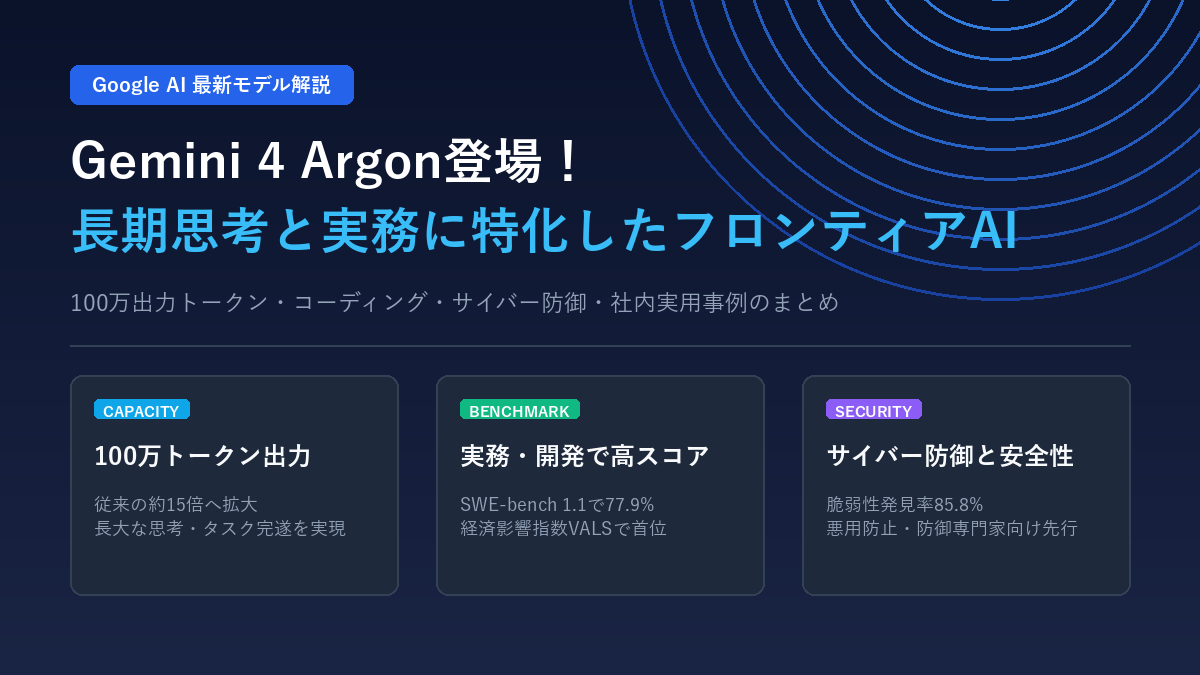
これまでの対話型モデルとは一線を画し、「長く入り組んだ課題を深く考え続け、自律してやりきる」ことを主眼に設計された実務特化型のAIです。
従来の約15倍となる出力トークン上限や、SWE-benchでの新記録、Google社内での大規模なシステム書き換え実績、そして防御専門家向けに先行公開されたサイバーセキュリティ機能など、注目すべきトピックが目白押しです。
本記事では、Gemini 4 Argonのモデル位置づけ、提供形態、料金体系、主要ベンチマークの結果、Google社内での実用事例、安全性対策まで要点を分かりやすく整理して解説します。
Gemini 4 Argonの概要と開発背景
Gemini 4 Argonは、単発の質問応答や短いコード補完ではなく、数時間から数日単位に及ぶ複雑な多段階推論タスクを完遂するために開発されたフロンティアモデルです。
特に以下の3つの実務領域にフォーカスして設計されています。
- ソフトウェア開発(コーディング):大規模リポジトリの改修、言語間移植、デバッグの自律実行
- 専門ナレッジ業務(法務・金融):膨大な判例や財務諸表の精査、長文レポートの作成
- サイバーセキュリティ防御:脆弱性の自律探索、検証、修正パッチの自動生成
表面的な知識量だけでなく、推論プロセスを粘り強く維持し続ける「長期的思考力(Long-horizon reasoning)」が本モデルの最大の武器となっています。
提供形態と気になる利用料金
Gemini 4 Argonは、その極めて高い実務遂行能力とサイバーセキュリティ関連機能を考慮し、段階的なロールアウト方式(段階的展開)が取られています。
まずは「Fairwind Program(フェアウィンド枠)」を通じて、信頼できるサイバー防御の専門家、政府機関、インフラ事業者などに限定提供されています。
一般公開日は現時点で未定ですが、今後APIの有料利用者およびGoogle AI Ultra契約者向けに順次展開される予定です。
APIの利用料金は、導入初期のプロモーション価格と将来の通常価格の2段階で設定されています。
| フェーズ | 入力料金(100万トークン) | 出力料金(100万トークン) | キャッシュ入力 |
|---|---|---|---|
| 導入プロモーション期間 | 2ドル | 10ドル | 95%割引(実質0.1ドル) |
| 導入期間終了後(通常予定) | 4ドル | 20ドル | コンテキストキャッシュ対応 |
特にコンテキストキャッシュの95%割引は強力で、大規模なコードベースや法律文書を常時読み込ませて反復利用するエンタープライズ用途において、コストを大幅に抑制できます。
出力トークン上限の拡大と技術的ブレイクスルー
Gemini 4 Argonの仕様の中で最も衝撃的なトピックの一つが、出力トークン上限の拡大です。
従来の主要モデルでは最大でも6万4000トークン程度に制限されていましたが、Gemini 4 Argonでは100万トークンへと一挙に拡大されました。
- 思考の途絶を防ぐ:長大な思考チェーン(CoT)や多段階の自己検証ループを途切れることなく継続可能
- 大規模コード・文書の直接出力:モジュール単位ではなく、複数ファイルにまたがる完全なプロジェクトコードや、数百ページ規模の分析レポートを一括出力
- 自律型エージェントの安定稼働:外部ツールの実行結果を受け取りながら、自らの内部状態を更新し続ける長時間タスクの完遂率が劇的に向上
主要ベンチマークスコアと得意分野
公式発表の比較表によると、全19項目の主要ベンチマークのうち、13項目で単独首位、1項目で同率首位を獲得しています。
業務自動化および専門業務での優位性
特に際立っているのが、実社会での経済的影響力や専門業務を測定するベンチマークです。
- VALS Index(経済影響評価):68.9%を記録し、トップに立ちました。
- Automation Bench(実務自動化):51.3%を達成。他社フラッグシップモデルに対して約10ポイントの差をつけています。
- Harveyベンチマーク(法務調査・書面作成):他社モデルが1桁台にとどまる中、19.6%を記録し、難解な法務実務における適性の高さを示しました。
コーディング性能と見えてきた課題
開発現場で最も注目されるコーディング能力については、長大なタスクで新記録を打ち立てた一方、環境による得手不得手も明確になっています。
- SWE-bench 1.1:77.9%の新記録を達成。実務規模のGitHub課題を解決する力において高い水準を証明しました。
- FrontierSWE 2:55.0%となり、比較対象となった4モデル中最下位という結果でした。
- ターミナル操作の評価:Terminal Bench 4.0やPostTrainBenchなど、一部のターミナル操作やリアルタイム対話環境においては他社モデルが優勢なスコアを残しています。
この結果から、Gemini 4 Argonは「コード全体の文脈を深く読み解き、大規模に設計・改修する」作業に圧倒的な強みを持つ一方、即時的なCLI操作や特定フレームワーク環境への適応にはまだ改善の余地があることが分かります。
科学・長文脈処理・マルチモーダルの実績
科学研究や長文読解、メディア理解においてもトップレベルの性能を示しています。
- 科学・数学:LabBench 2で88.8%、Beemath Benchで76.0%を獲得。
- 超長文脈処理(Graphwalks):25万6000〜100万トークンの長文脈評価で84.2%を記録。入力コンテキストが長くなればなるほど、他社モデルとの性能差が広がる傾向が見られます。
- マルチモーダル理解:長尺動画を理解するLV-Benchで91.7%、複雑なグラフ解析を行うChartQAで71.6%を記録し、視覚・動画理解でも首位を維持しています。
Google社内ですでに実証されている活用事例
Gemini 4 Argonの特筆すべき点は、机上の研究段階にとどまらず、公式発表の前にGoogle社内の数千人規模のエンジニアが実務にフル活用していたという実績です。
公開された実用事例には、実用性の高さを示す具体的な数字が並んでいます。
- 量子コンピューターの効率化:部品効率向上タスクをわずか数分で40%改善。
- データセンターの最適化:システム全体の稼働ログを自律的に精査し、300テラバイト以上のメモリーの無駄を解消。
- 80万行コードのRust書き換え:80万行を超えるレガシーなC/C++コードを、メモリ安全性の高いRust言語へ自律的に書き換え。
- 動画デコーダーの高速化:3万2000行の動画デコーダー処理をリファクタリングし、画質を一切損なうことなく処理速度を2.7倍に向上。
数十万行規模のコードベース移行やインフラの自律最適化など、従来のAIでは分割して人間が細かく指示を出さなければ不可能だった作業を、ひとまとまりのプロジェクトとして完遂できる実力を証明しています。
サイバー防御機能と多重の安全性対策
Gemini 4 Argonの最も重要な柱の一つが、サイバーセキュリティ分野への貢献です。
脆弱性の自律的検知と修正パッチ
ソースコードの静的検査における脆弱性発見率は85.8%、ソースコードなしの侵入テスト環境でも70.9%を記録し、前世代から12ポイント以上の向上を達成しました。
システムの脆弱性を早期に特定し、攻撃者に悪用される前に自動で修正パッチを生成する「守りのAI」として機能します。なお、防御専門家や社内向けには、サイバー機能の制限を解除した特別バージョンが提供されています。
悪用防止と多重のセーフガード
強力すぎる能力が悪用されるリスクを防ぐため、厳格な安全基準が組み込まれています。
- 悪用拒絶の強化:兵器関連、サイバー攻撃、破壊工作などを目的としたプロンプトを確実に拒絶。
- プロンプトインジェクション耐性:敵対的入力に対する耐性テストで、突破率わずか0.7%という極めて堅牢な数値を記録。
- 多重の安全対策:思考プロセスのリアルタイム監視、隔離されたサンドボックス環境での出力評価など、4つの安全レイヤーを常時稼働。
まとめと今後の展望
Gemini 4 Argonは、AIが「質問に答えてくれるツール」から「複雑なプロジェクトを自律してやりきる実務パートナー」へと本格的に進化したことを示すマイルストーンと言えます。
現在は専門家向けの限定公開ですが、今後API有料ユーザーやGoogle AI Ultra契約者へ順次展開されることで、ソフトウェア開発や法務・金融、セキュリティ運用の現場に大きな変革をもたらすことが期待されます。
・100万トークン出力により長大な思考と作業の持続が可能に
・法務(Harvey)や業務自動化(Automation Bench)で他社をリード
・Google社内で80万行コードの言語移行やインフラ効率化を実証済み
・サイバー防御の強化と突破率0.7%の強固な安全性設計


