文章を生成せず「判断」だけを高速・低コストに出力する新しいAIモデル
生成AIやLLMをシステムに組み込む際、「問い合わせの担当チーム自動振り分け」「投稿のスパム判定」「感情スコアの算出」などのタスクで、長文の文章生成は不要なのにJSON出力のために数秒待たされた経験はありませんか?
こうした「分類・採点・分岐判定」に特化し、文章を一切書かずに確率と確信度だけを返す新しいAIモデル「Jev(ジェブ)」が登場しました。
本記事では、Jevの基本概念や従来のLLMとのアーキテクチャの違い、3種類の判断型(Choice / Score / Noul)、確信度を活用したプログラム制御の設計、そしてPythonによる実装例まで分かりやすく解説します。
Jevとは?文章を生成しない「System One Model」
「Jev(ジェブ)」は、TypeSafe AI社が公開した、高速な意思決定・判断の出力に特化した新しいAIモデルです。
従来のChatGPTやClaudeのような大規模言語モデル(LLM)は、プロンプトに対して単語(トークン)を順番に紡ぎ出して自然な文章を生成します。これに対し、Jevは「あらかじめ定義された選択肢や尺度に対して、確率と確信度を返す」という動作に特化しています。
心理学における思考プロセス「システム1(直感・即座の判断)」と「システム2(論理的思考・熟慮)」の分類になぞらえ、Jevのようなモデルは「System One Model」と呼ばれます。
プログラミングの視点で見れば、自然言語の文脈を深く理解したうえで高速に分岐してくれる「賢いif文」のような役割を果たします。
Jevの主な特徴
- 高速な応答速度:公称70〜500ミリ秒で高速に判断を返却
- 低コストな料金体系:入力100万トークンあたり0.042ドル、出力トークン課金は不要(無料)
- 構造上の型安全:定義されていない未知のキーや選択肢外の文字列を出力する構文エラーが発生しない
- 複数判定の並列評価:1回のリクエストに複数の異なる質問を含めても、並列に一括評価されるためレイテンシが増えにくい
記述式とマークシートの違いで理解するJevの構造
Jevと従来のLLMの違いを理解するには、「記述式のテスト」と「マークシート式のテスト」の対比が役立ちます。
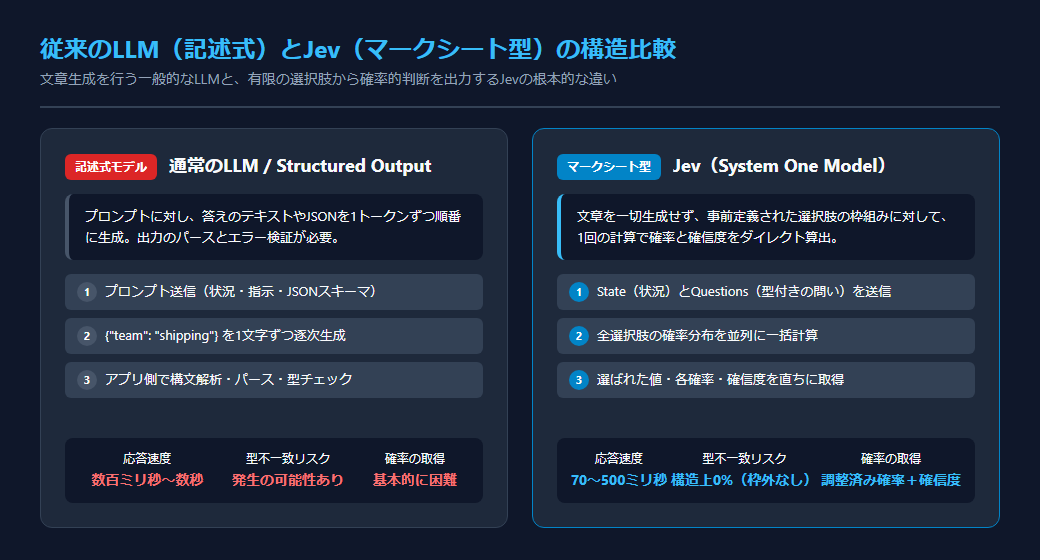
▲ 記述式で逐次生成する従来のLLMとマークシート型で全選択肢を並列評価するJevの比較
従来のLLMやStructured Outputの特性と課題
たとえばECサイトで「届いたレビューを担当部署へ振り分ける」場合、通常のLLMでは次のように処理します。
- プロンプトに「以下のレビューを読み、担当チーム名をJSONで答えてください」と指示する。
- LLMは「{」「”team”:」「”shipping”」「}」と、1トークンずつ順番に文字を生成していく。
- 受け取ったプログラム側でJSONをパースし、キーの存在確認や型バリデーションを行う。
Structured Outputなどの機能によりJSON形式の遵守精度は向上したものの、文字列を順次生成するオーバーヘッドや推論コスト、構文解析の手間は依然として残ります。
また、「なぜその回答に至ったのか」「どれくらい自信があるのか」といった客観的な確率分布を把握することは容易ではありません。
マークシート方式による並列確率計算の強み
Jevは「マークシート」のように機能します。
プログラム側が「shipping(配送)」「product(製品)」「payment(決済)」「other(その他)」という枠を用意して渡すと、Jevは各選択肢に対して「どの欄をどれくらいの確からしさで塗るか」を1回の計算で算出します。
文章を生成するプロセスが存在しないため、応答が極めて高速であり、指定した選択肢の枠組みから外れた回答が出る構文エラーも発生しません。
さらに、単一の答えだけでなく「各選択肢の確率のばらつき」や「確信度」が手に入るため、プログラム側でより柔軟な制御が可能になります。
Jevが提供する3つの判断型
Jevの入出力構造は、「State(状況・データ)」に対して「Questions(型付きの問い)」を投げ、「Typed Decisions(型付きの判断)」を受け取るという設計になっています。
質問には、用途に応じた3種類の型が用意されています。
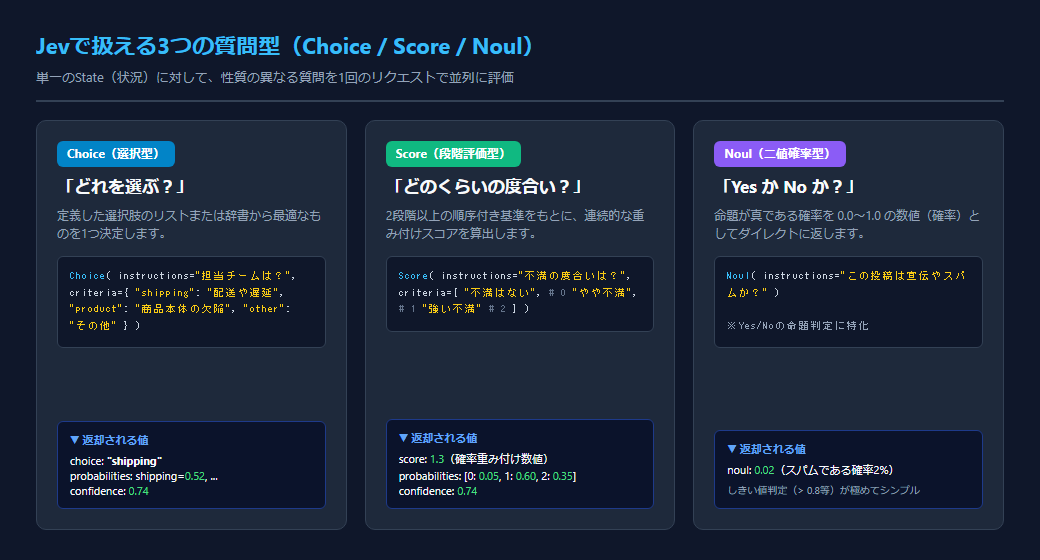
▲ Jevが提供するChoice(選択)、Score(段階評価)、Noul(二値確率)の3型
Choice(選択肢から1つを選ぶ)
複数の候補の中から最適なものを1つ選ぶ型です。問い合わせのカテゴリ分類やエージェントの次アクション選択などに適しています。
各選択肢にラベルと説明(criteria)を定義して渡します。
- 返却値:選ばれた選択肢(choice)、全選択肢の確率分布(probabilities)、確信度(confidence)
Score(段階的な評価値・度合い)
「どのくらい不満か」「危険度の高さはどの程度か」など、連続的な強さや順序付きの度合いを評価する型です。
2段階以上の基準(例:「安全」「やや注意」「危険」)を配列で指定します。
- 返却値:確率で重み付けされた連続数値(score)、各基準の確率(probabilities)、確信度(confidence)
単に「1」や「2」といった整数を返すのではなく、確率分布をもとに重み付けした連続値(例:1.3など)が返却されるため、微細なニュアンスの違いを数値として把握できます。
Noul(Yes / Noの二値確率)
命題に対して「YesかNoか」を判断する二値判定型です。「この投稿はスパムか」「即時対応が必要か」などの判定に適しています。
- 返却値:命題が真である確率(0.0〜1.0)
しきい値(例:0.8以上ならスパム隔離)によるシンプルな条件判定を容易に記述できます。
確信度(confidence)を活用したプログラム制御
Jevの大きな強みのひとつが、回答とともに返却される「確信度(confidence)」の存在です。
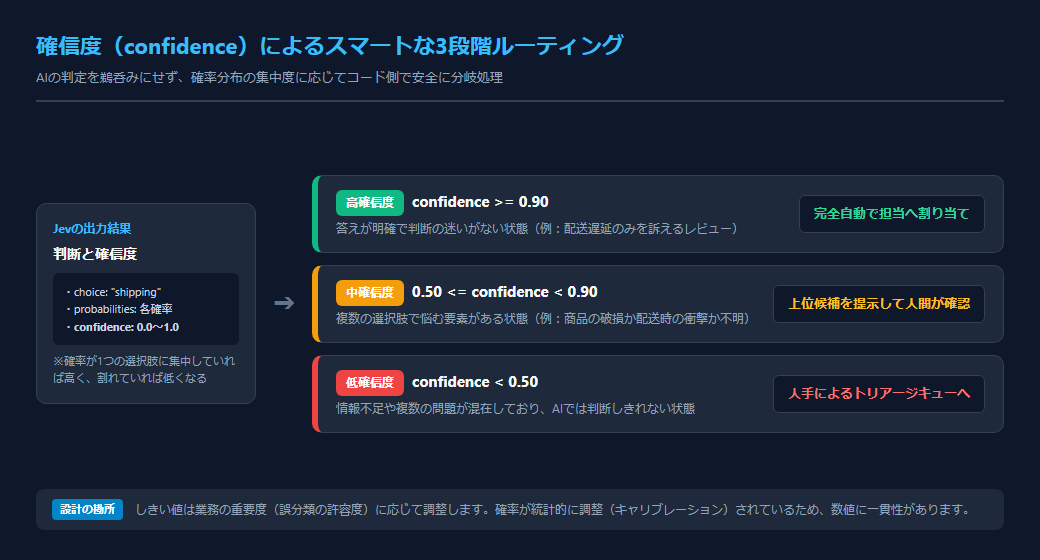
▲ 確信度の高さに応じて自動化と人間連携を切り替える3段階設計
確率のキャリブレーション(調整)の重要性
AIモデルの判定を実務に組み込む際、「AIが自信満々に間違える」リスクは常に課題となります。
Jevでは、出力される確率が統計的に「キャリブレーション(調整)」されるよう設計されています。
キャリブレーションされているとは、「確率80%」と予測された事象を多数集めると、そのうち約8割が実際に正解となるような整合性を持つ状態を指します。
確信度に応じた3段階ルーティングの実装パターン
確信度(confidence)は、選択肢ごとの確率のばらつきをもとに0〜1の範囲で算出されます。
確率が1つの選択肢に集中していれば確信度は1に近づき、複数の選択肢で意見が割れていると確信度は低くなります。
この仕組みを利用して、実務コードでは以下のような「3段階ルーティング」を組むのが効果的です。
team_result = response.choices["assigned_team"]
confidence = team_result.confidence

# 業務の許容度に応じてしきい値を設定
if confidence >= 0.90:
    # 高確信度:判断が極めて明確なため、自動で該当チームに振り分け
    assign_to_team(team_result.choice)
elif confidence >= 0.50:
    # 中確信度:候補が割れているため、上位候補を画面に提示して人間がワンクリック選択
    show_candidates_for_review(team_result.probabilities)
else:
    # 低確信度:情報不足や判断困難なため、人手による総合トリアージキューに送る
    send_to_manual_triage_queue()
このように設計することで、ルーチン的な判断は完全自動化しつつ、判断が難しいグレーゾーンの案件だけを効率的に人間へエスカレーションできます。
Python SDKとAPIによる実装方法
Jevは公式のPython SDKまたは標準的なHTTP API(REST)を通じて簡単に利用できます。
環境準備とSDKの導入
公式SDKはPython 3.10以上に対応しています。pipまたはuvを用いてインストールします。
pip install typesafe-sdkAPIキーを取得後、環境変数「TYPESAFE_API_KEY」に設定します。
export TYPESAFE_API_KEY="your-api-key-here"Python SDKによる問い合わせ分類の実装コード
以下は、ユーザーから届いたレビュー内容に対して「担当チーム(Choice)」「不満度(Score)」「スパム判定(Noul)」の3つの質問を1回のリクエストで並列処理するコード例です。
from typesafe_sdk import TypeSafeClient, Choice, Score, Noul

# 判定対象のテキスト(State)
review_text = (
    "届いたダンボールが潰れており、中のグラスも割れていました。"
    "至急交換の手続きをお願いしたいです。"
)

with TypeSafeClient(model="jev-latest") as client:
    response = client.system_one(
        state=review_text,
        questions={
            "team": Choice(
                instructions="この問い合わせを最初に確認すべき担当部署はどこですか?",
                criteria={
                    "shipping": "配送中の破損・遅延・誤配送に関する問題",
                    "product": "製品本体の初期不良・仕様・品質に関する問題",
                    "billing": "決済・請求・返金に関する問題",
                    "other": "上記のいずれにも該当しない内容"
                }
            ),
            "dissatisfaction": Score(
                instructions="顧客の不満の度合いを評価してください",
                criteria=[
                    "不満はない(中立・好意的)",
                    "やや不満がある",
                    "非常に強い不満・怒りがある"
                ]
            ),
            "is_spam": Noul(
                instructions="この投稿は宣伝・嫌がらせ等のスパムですか?"
            )
        }
    )

# 結果の取得
assigned_team = response.choices["team"]
dissatisfaction_score = response.scores["dissatisfaction"]
spam_noul = response.nouls["is_spam"]

print("担当チーム:", assigned_team.choice)
print("担当確信度:", assigned_team.confidence)
print("不満度スコア:", dissatisfaction_score.score)
print("スパム確率:", spam_noul.noul)
実行結果では、3つの質問すべてに対する結果が1つのオブジェクトとして即座に得られます。
複数の質問を投げてもサーバー側で並列評価されるため、処理時間の増加を抑えられます。
HTTP API(cURL)による呼び出し
SDKを使用しない言語や環境でも、標準的なREST APIエンドポイントへJSONをPOSTすることで簡単に連携可能です。
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "届いたダンボールが潰れており、中のグラスも割れていました。",
    "questions": {
      "team": {
        "type": "choice",
        "instructions": "担当部署を選択してください",
        "criteria": {
          "shipping": "配送中の破損や遅延",
          "product": "製品の不良"
        }
      },
      "is_spam": {
        "type": "noul",
        "instructions": "スパム投稿ですか?"
      }
    }
  }'
Jevの実務での活用場面と注意点
Jevはその特性上、非常に得意なユースケースがある一方で、従来のLLMに任せるべき不得意な領域も明確に分かれています。
Jevが得意とするユースケース
- 問い合わせやチケットの自動振り分け:受信した瞬間に部署・優先度・緊急度を判定して自動ルーティング
- 投稿コンテンツのリアルタイムモデレーション:SNS投稿やレビューの規約違反チェック、不適切表現の事前スクリーニング
- AIエージェントの状態遷移・ツール選択:自律型エージェントの「次に行うべきアクション」を高速に分岐決定
- ドキュメント・要件定義書の多角的レビュー:文章に対して「整合性」「具体性」「リスク」など複数の観点から一括スコアリング
Jevが不得意とする領域と使い分け
Jevは「限られた選択肢からの確率評価」に特化しているため、以下のようなタスクには適していません。
- 文章の執筆・要約・翻訳:自然言語の文章を生成する機能自体を持たないため、返信文の作成などは通常のLLMを併用する必要があります。
- 厳密な数値計算や日付比較:「3日後と5日後のどちらが先か」といった論理計算や数値演算は不得意とされています。
- 選択肢の誤認:未知の形式を返す構文エラーは防げますが、用意された選択肢の中で誤ったものを選ぶ論理的ミスの可能性は存在します。
実務でのベストプラクティス:ハイブリッド構成
一次受けの高速な振り分けや感情スコアリング、スパムチェックは低コストな「Jev」に任せ、顧客への丁寧な返信文生成や複雑な要約処理は「Claude」や「GPT-4o」などの生成モデルに引き渡す、というハイブリッドなパイプラインを組むことで、システムの応答速度と運用コストを改善できます。
まとめ
Jevは、「文章を生成せず判断だけを返す」というアプローチにより、AIによる自動判定・ルーティングを高速性と低コストで実現するモデルです。
- マークシート型の確率評価により、型エラーのない高速判定(70〜500ms)を実現
- Choice(選択)、Score(段階評価)、Noul(二値確率)を1リクエストで並列処理
- キャリブレーションされた確率と確信度を活用し、完全自動と人間連携を安全にルーティング
- 生成モデルとのハイブリッド構成により、システム全体のコスト削減と高速化が可能
システム開発において「AIに文章は書かせなくていいが、文脈に応じた賢い分岐を行わせたい」というケースでは、JevのようなSystem One Modelが有力な選択肢となるでしょう。


