カンマ区切りの複数回答集計を手作業ゼロで自動化するテクニック
Googleフォームなどで「複数選択可(チェックボックス)」のアンケートを実施した際、スプレッドシートに届く回答が「Python, SQL, データ分析」のように1つのセルにカンマ区切りで保存されて困った経験はありませんか?
通常のCOUNTIF関数では部分一致の誤判定が発生しやすく、かといって手作業でコピーして分解するのは多大な手間がかかります。
この記事では、SPLIT、FLATTEN、QUERY、FILTERをスマートに組み合わせ、数式を1つ配置するだけで項目ごとの投票数を自動集計するモダンな方法を分かりやすく解説します。
複数選択アンケートの集計で直面する課題
Googleフォームのチェックボックス質問に対する回答は、連携されたGoogleスプレッドシートの1つのセルの中に「カンマ(,)区切り」でまとめて記録されます。
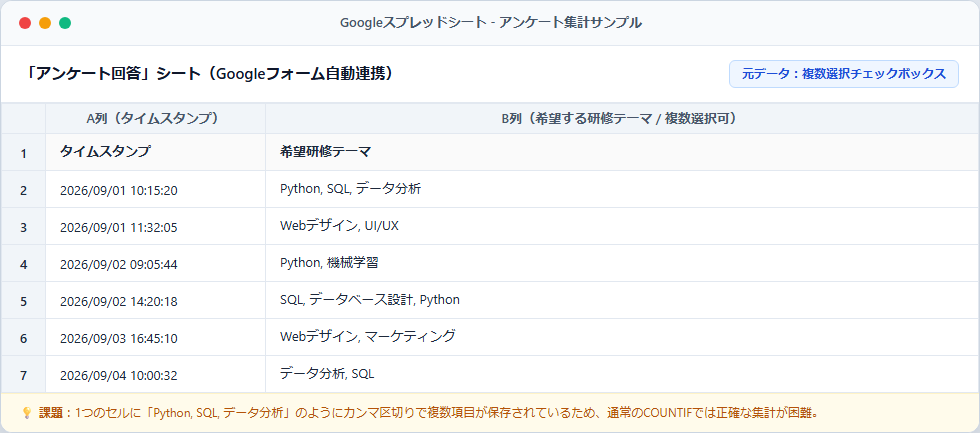
アンケート回答シートの元データ例(B列にカンマ区切りで回答が蓄積される)
このような形式のデータを集計しようとすると、主に以下の2つの壁に直面します。
- あいまい検索の誤検知:例えば「COUNTIF(B:B, “*Java*”)」のようにワイルドカードを使うと、「Java」を数えたいのに「JavaScript」まで一緒にカウントされてしまいます。
- 手動分割の破綻:「テキストを列に分割」機能でセルを分ける方法もありますが、新しい回答が送信されるたびに手動操作をやり直す必要があり、自動化できません。
この問題を根本から解消するのが、スプレッドシートの配列操作関数を組み合わせた自動集計数式です。
完成コードとサンプルデータの構成
まずは、実際に使用する完成数式とシートの構成を確認しましょう。
=IFERROR(QUERY(FLATTEN(ARRAYFORMULA(TRIM(SPLIT(FILTER('アンケート回答'!B2:B, INT('アンケート回答'!A2:A)>=C2, INT('アンケート回答'!A2:A)<=C3, IF(OR($E$3="", $E$3="(すべて)"), 'アンケート回答'!A2:A>0, IFERROR(REGEXMATCH('アンケート回答'!B2:B, "(?i)(^|[,、])\s*" & REGEXREPLACE($E$3, "([\^$.*+?()[\]{}|])", "\$1") & "\s*([,、]|$)"), FALSE))), ",")))), "select Col1, count(Col1) where Col1 is not null and Col1 <> '' group by Col1 label count(Col1) ''", 0), "データなし")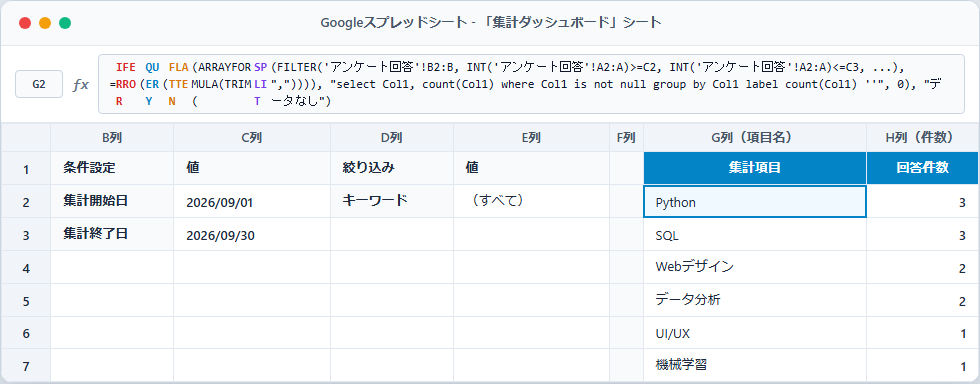
集計ダッシュボード(G2セルに数式を入力するだけで項目名と件数がスピル展開される)
シート構成の前提
| シート・セル | 役割と入力内容 |
|---|---|
| ‘アンケート回答’!A2:A | 回答送信日時(タイムスタンプ) |
| ‘アンケート回答’!B2:B | 複数選択回答(例: Python, SQL, データ分析) |
| 集計シート C2 / C3 | 集計開始日(C2)と集計終了日(C3) |
| 集計シート E3 | 特定キーワードでの絞り込み(「(すべて)」または空欄で全件対象) |
| 集計シート G2 | 上記の完成数式を入力するセル(結果がG列・H列に自動出力) |
FLATTENとQUERYを組み合わせた集計の仕組み
この数式は一見長く複雑に見えますが、「絞り込み ➔ 分割 ➔ 1列化 ➔ 集計」という明確なステップで順にデータを加工しています。
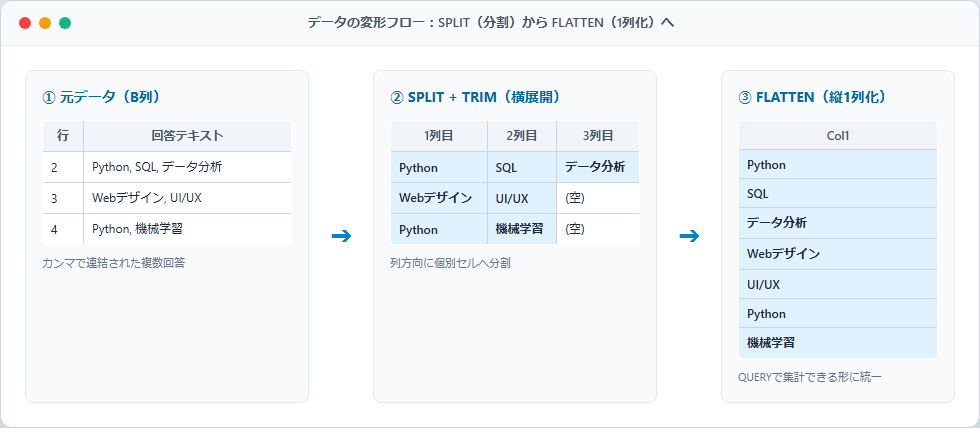
データの変形フロー(SPLITで横に分けたものをFLATTENで縦1本に集約する)
期間や条件で回答データを絞り込む(FILTER関数)
最初に、対象となる回答行だけを「FILTER関数」で抽出します。
FILTER(
  'アンケート回答'!B2:B,
  INT('アンケート回答'!A2:A)>=C2,
  INT('アンケート回答'!A2:A)<=C3,
  IF(OR($E$3="", $E$3="(すべて)"), 'アンケート回答'!A2:A>0, ...)
)
ここでは2つのテクニックが使われています。
- INT関数による日付丸め:タイムスタンプには時刻情報が含まれているため、INT関数を通すことでシリアル値の小数部を切り捨て、純粋な日付として比較できるようにしています。
- 条件の動的切り替え:E3セルが「(すべて)」または空欄のときは「A2:A > 0」により全行を通過させ、特定キーワードが入っている場合は正規表現で該当する行のみを通過させます。
カンマ区切りテキストをセルごとに分割する(SPLIT・TRIM・ARRAYFORMULA)
抽出された回答テキストを、項目ごとに分解します。
ARRAYFORMULA(TRIM(SPLIT(抽出結果, ",")))- SPLIT(…, “,”):「Python, SQL, データ分析」をカンマで区切り、右方向の別々のセルへ分割します。
- TRIM(…):カンマの直後に入りがちな半角スペースを除去し、「 SQL」を綺麗な「SQL」に整えます。
- ARRAYFORMULA(…):通常は単一セルにしか効かないSPLITとTRIMを、複数行の全回答に対して一括適用します。
複数列に広がった回答を縦1列にまとめる(FLATTEN関数)
SPLITによって行と列に広がった2次元データを、Googleスプレッドシート独自のモダン関数「FLATTEN(フラット)」で縦1列のリストへ変換します。
FLATTEN関数の役割:
通常のデータベースや集計関数は「1つの列」に並んだデータを対象にするのが得意です。FLATTEN関数を使うことで、何列に分かれていようとも、すべての回答項目を1本の長い配列として連結できます。
項目ごとにグループ化して件数を集計する(QUERY関数)
縦1列になった全回答データに対して「QUERY関数」を実行し、出現回数を集計します。
QUERY(
  FLATTEN(...),
  "select Col1, count(Col1) where Col1 is not null and Col1 <> '' group by Col1 label count(Col1) ''",
  0
)- where Col1 is not null and Col1 <> ”:SPLITによって生じた余分な空白セルを除外します。
- group by Col1:項目名(Python、SQL等)ごとにまとめて重複をまとめます。
- select Col1, count(Col1):項目名と、その出現回数(投票数)を横並びで出力します。
- label count(Col1) ”:自動的に付与される「count」というヘッダー名を非表示にします。
エラーを非表示にして表示を整える(IFERROR関数)
最後に全体を「IFERROR(…, “データなし”)」で囲みます。
指定した日付範囲内に該当する回答が1件もない場合でも、「#N/A」などの数式エラーを出さず、落ち着いた表示を保つことができます。
実務で役立つカスタマイズと注意点
区切り文字が読点「、」の場合の対処法
アンケート回答の区切り文字が日本語の読点「、」や改行になっている場合は、SPLITの第2引数を調整するか、事前にSUBSTITUTEでカンマに統一します。
SPLIT(SUBSTITUTE(対象範囲, "、", ","), ",")正規表現による完全一致の仕組み
FILTER条件内の「REGEXMATCH」では、以下の正規表現パターンを採用しています。
"(?i)(^|[,、])\s*" & REGEXREPLACE($E$3, "([\^$.*+?()[\]{}|])", "\$1") & "\s*([,、]|$)"この正規表現には2つの安全策が組み込まれています。
- 単語境界の担保:「(^|[,、])」と「([,、]|$)」で挟むことで、カンマや文頭・文末で区切られた完全な1単語としてマッチングします。「Java」を検索した際に「JavaScript」がヒットしてしまう誤検知を完全に防ぎます。
- 特殊記号のエスケープ:REGEXREPLACEによって検索キーワードに含まれる「+」や「(」などの正規表現メタ文字を自動エスケープするため、どのような単語が入力されても構文エラーを起こしません。
まとめ
- SPLIT ➔ FLATTEN ➔ QUERYの連携:1つのセルに収まったカンマ区切りデータを自動で分解し、縦1列に揃えてからグループ集計する王道のモダンパターン。
- 手動更新の手間をゼロに:Googleフォームから新しい回答が送信されると、集計表もリアルタイムに自動更新される。
- 部分一致の誤検知を防ぐ:正規表現の単語境界判定により、類似した名称の選択肢も正確に判別可能。
- 美しいシート表示:IFERRORとQUERYのラベル制御により、余計なエラーやヘッダーを出さず洗練されたダッシュボードを作成できる。
アンケートの複数選択集計に時間を取られていた方は、ぜひこの関数コンビネーションをテンプレートとして活用し、スムーズで正確な自動集計環境を整えてみてください。


