従来のRPAや自動化スクリプトとは異なり、事前の厳密なルール設計がなくても、自然言語で指示を出すだけでAIが状況を判断しながらクリックや文字入力を進めてくれます。
この記事では、ブラウザ操作AIエージェントの基本的な仕組みや従来の自動化ツールとの違い、代表的なサービス・ツールの特徴(公式リンク付き)、導入時の注意点について分かりやすく整理して解説します。
ブラウザ操作AIエージェントとは?自然言語でWebを自律操作する仕組み
ブラウザ操作AIエージェントとは、大規模言語モデル(LLM)やマルチモーダルAIが、Webブラウザの画面情報をリアルタイムに読み取り、ユーザーが与えた目的に向かって自律的にマウス操作やキーボード入力、ページ遷移を繰り返すシステムのことです。
ユーザーは「このサイトで検索をして上位3件の情報をまとめて」「指定した条件で予約フォームに入力して」といった自然言語でゴールを伝えるだけで済みます。AIは画面全体のスクリーンショットやHTMLのDOM構造、アクセシビリティツリーを解析し、「次はどのボタンを押すべきか」「どこに文字を入力すべきか」を自ら推論して実行します。
画面を認識して自律的に手順を組み立てる技術
AIエージェントがブラウザを操作する背後では、「観測(Observation)」「思考・計画(Reasoning / Planning)」「行動(Action)」のサイクルが高速に回っています。
AIエージェントがブラウザを操作する基本サイクル
- 1. 画面の観測:現在のWebページのスクリーンショットやHTML構造を取得し、UI要素を把握する
- 2. 次の行動の思考:目的を達成するために「どのボタンをクリックするか」「何を入力するか」を推論する
- 3. 操作の実行:ブラウザ自動化プロトコル(CDPやWebDriver等)を介してクリックやキーストロークを実行する
- 4. 結果の検証:画面遷移やエラーの有無を確認し、目標達成までこのループを繰り返す
このサイクルにより、予想外のポップアップ表示やページ読み込みの遅延が発生しても、AIが現在の状況を見直して臨機応変に対応できる点が大きな強みとなっています。
従来のRPAや自動化スクリプトとの違い
これまでブラウザ操作の自動化といえば、SeleniumやPlaywright、Puppeteerといったライブラリを用いたプログラミング、あるいはエンタープライズ向けのRPA(Robotic Process Automation)ツールが主流でした。
従来の自動化とAIエージェントでは、根本的な思想が異なります。従来のツールは「あらかじめ指定された手順を1コマずつ正確にトレースする」アプローチです。そのため、WebサイトのHTML構造やCSSクラス、ボタンの位置が少し変更されただけで、要素を見失って停止してしまいます。
一方、AIエージェントは「目的(ゴール)」を与えられて動作します。画面レイアウトが変わっても、AIが視覚情報や文脈から「これがログインボタンに該当する」と自律的に判断するため、Webサイトの頻繁なデザイン変更に対しても壊れにくいという特性を持っています。
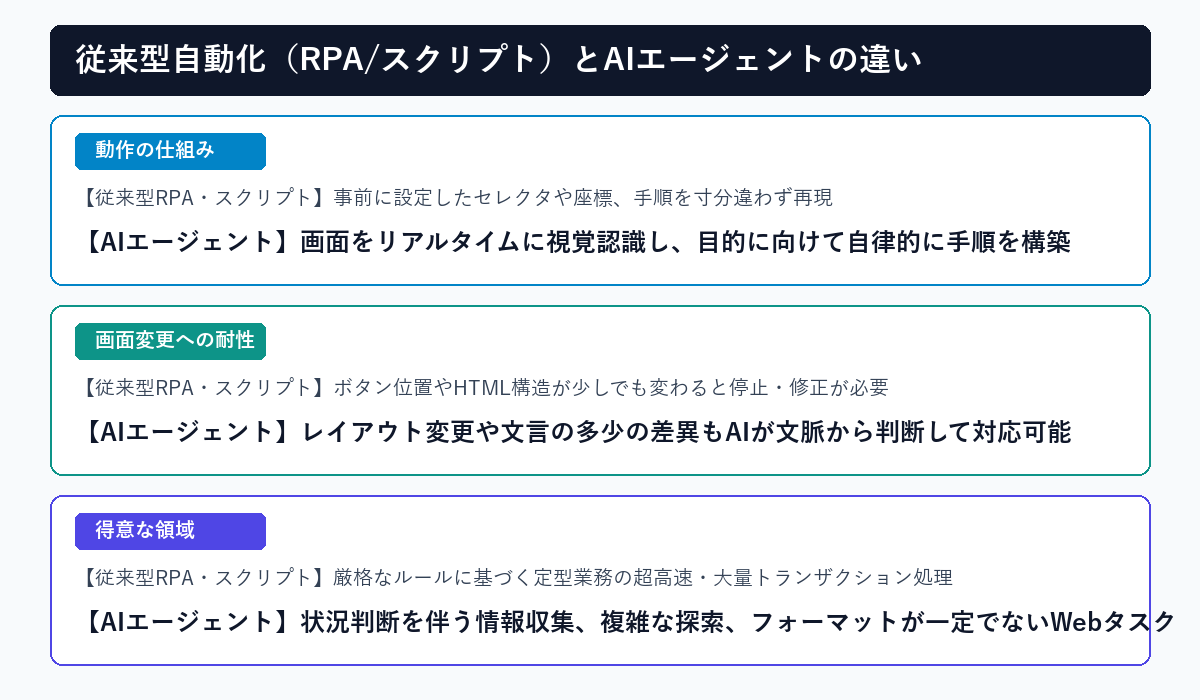
従来型自動化(RPA/スクリプト)とAIエージェントのアプローチの違い
従来型自動化とAIエージェントの比較
従来型の自動化(RPA・スクリプト)とAIエージェントの特徴を比較表にまとめました。どちらかが完全に上位互換というわけではなく、業務の性質に応じた適材適所の使い分けが基本となります。
| 比較項目 | 従来型自動化(RPA / スクリプト) | ブラウザ操作AIエージェント |
|---|---|---|
| 動作の基本原則 | 事前に設定された手順・セレクタを厳格に再現 | 目的に向けて画面を認識し、自律的に手順を決定 |
| 画面変更への耐性 | 低い(HTMLやレイアウトの変更でエラー停止) | 高い(文脈や視覚情報から柔軟に要素を認識) |
| 得意な業務 | フォーマットが固定された定型業務の高速・大量処理 | 判断を伴う情報探索、データ収集、多様なサイト操作 |
| 処理の確実性 | 極めて高い(決めた通りにしか動かない) | プロンプトや画面状態により試行錯誤が発生する場合あり |
| 初期設計コスト | セレクタ指定や例外処理の作り込みが必要 | 自然言語による指示出しで即座に開始可能 |
たとえば、社内の基幹システム間で決まったデータをミリ秒単位の正確さで大量転記するような処理には、従来型のRPAやAPI連携が向いています。一方で、「競合サイトの価格情報を定期的に見回り、表記ゆれがあっても特定の商品データを拾い出す」といった柔軟性が求められるタスクには、AIエージェントが強みを発揮します。
ブラウザ操作を自動化する代表的なAIエージェントとアプローチ
現在、ブラウザ操作の自律実行を実現するためのツールやフレームワークは、オープンソースから大手AI企業のクラウドサービスまで多岐にわたります。代表的な6つのアプローチと公式リンクを紹介します。
Browser Use(オープンソースの自律ブラウジングフレームワーク)
Browser Useは、Pythonベースで開発されているオープンソースのWebエージェントフレームワークです。
Playwrightと大規模言語モデル(GPT-4o、Claude、Geminiなど)を組み合わせ、Webブラウザをプログラム経由で直接操作します。自社のサーバーやローカル環境で自由に稼働させることができ、特定の社内システムやデータベースと密接に連携させたカスタムエージェントを構築する用途に選ばれています。
🔗 公式リンク:Browser Use 公式サイト | GitHub リポジトリ
OpenAI Operator(Webタスクを自律実行するブラウジングエージェント)
OpenAIが提供するOperator(ChatGPTのエージェント機能)は、Webブラウザを用いた複雑なタスクを代行するために設計されたエージェントです。
ユーザーがチャットインターフェースから指示を出すと、バックグラウンドの仮想ブラウザ上でページの検索、フォームへの入力、カートへの追加、情報抽出などの一連の作業を代行します。単発のWebリサーチやオンライン手続きをスムーズに完了させたい用途に適しています。
🔗 公式リンク:OpenAI 公式サイト | ChatGPT
Anthropic Claude Computer Use(デスクトップ全体を操作する基盤技術)
Anthropicが公開した「Computer Use」は、ブラウザ単体に留まらず、パソコンの画面全体をスクリーンショットとして認識し、マウス移動、クリック、キーストロークを直接実行できる技術です。
Webブラウザでダウンロードしたファイルをローカルのエディタで開き、加工した上で別のWebフォームにアップロードするといった、ブラウザとデスクトップアプリをまたぐ一連の作業を自動化できる点が最大の特徴です。
🔗 公式リンク:Anthropic 公式サイト | Computer Use ドキュメント
Google Geminiによるブラウザ支援(検索・Workspace連携)
Googleのエコシステムでは、ChromeブラウザやGoogle Workspaceと深く連携したエージェント機能が展開されています。
Chrome上で開いているWebページの文脈を読み取り、要約を作成したり、複数のタブを横断して比較表を作成したり、GoogleスプレッドシートやGmailとスムーズにデータを往復させたりといった、日常的な情報処理業務を効率化できます。
🔗 公式リンク:Google Gemini 公式サイト
Perplexity Comet(リサーチと情報探索に特化したエージェントブラウザ)
AI検索サービスで高い支持を得ているPerplexityは、リサーチと情報収集を自律的に深掘りするエージェント機能を備えています。
単に1つのページを閲覧するだけでなく、検索結果から複数のリンクを巡回し、信頼性の高い情報源を照合しながら回答をまとめるなど、調べ物や市場調査におけるWebブラウジングの自動化に強みを持っています。
🔗 公式リンク:Perplexity 公式サイト
PlaywrightやPuppeteerとLLMを組み合わせた独自開発
既存のツールをそのまま利用するだけでなく、開発者がPlaywrightやPuppeteerといったブラウザ自動化ライブラリと、LLMのFunction Calling(Tool Calling)機能を組み合わせて独自の自律エージェントを内製する事例も増えています。
「現在の画面のアクセシビリティツリーを取得する関数」「クリックする関数」「入力する関数」をツールとしてLLMに渡し、モデルに次に呼び出すべきアクションを判断させることで、自社のセキュリティ要件に適合した専用システムを柔軟に構築できます。
🔗 公式リンク:Playwright 公式サイト | Puppeteer 公式サイト
主要ツールの特徴比較
紹介したアプローチやツールの提供形態や特徴を整理しました。リンクから各ツールの詳細ページをご確認いただけます。
| ツール・手法 | 提供形態 | 操作対象 | 主な強み | 導入難易度 |
|---|---|---|---|---|
| Browser Use | オープンソース(OSS) | ブラウザ | 高い拡張性・自社環境での自由な運用 | 開発スキルが必要 |
| OpenAI Operator | クラウド(Webサービス) | 仮想ブラウザ | 自然言語による手軽なWebタスク代行 | 容易(UIから利用) |
| Claude Computer Use | API / クラウド | PC画面全体 | ブラウザ外のデスクトップアプリも横断操作 | API連携・環境構築が必要 |
| Geminiブラウザ支援 | クラウド(ブラウザ統合) | Chromeタブ | Google検索やWorkspaceとのスムーズな親和性 | 容易(設定で利用) |
| Perplexity Comet | 専用ブラウザ / クラウド | Web検索・閲覧 | 複数情報源を横断した高度なリサーチ自動化 | 容易(直感的操作) |
| Playwright + LLM内製 | 自社実装コード | ヘッドレスブラウザ等 | 自社セキュリティや独自業務に完全フィット | 高度な設計・開発が必要 |
ブラウザ操作AIエージェントを導入する際の注意点
AIエージェントは非常に強力な自動化手段ですが、導入・運用にあたっては留意しておくべき技術的・運用上のポイントがあります。
重要な操作における人間の確認(Human-in-the-loop)
AIエージェントは自律的に判断して行動するため、意図しない解釈や誤認が発生するリスクが常に存在します。
閲覧やデータ抽出といった「読み取り系」のタスクであれば安全ですが、送金、決済、発注、データベースの削除、重要メールの送信といった「後戻りができない書き込み系の操作」を伴う場合は、最終確認を人間が承認する仕組み(Human-in-the-loop)を必ず設けておくことが重要です。
認証情報とセキュリティの管理
ログインが必要な社内システムや機密情報を扱うWebサービスを操作させる場合、認証情報の受け渡し方法に配慮が必要です。
IDやパスワードを平文でプロンプトに含めないようにすることはもちろん、セッションクッキーの管理や、クラウド型エージェント利用時のデータ保持ポリシー(送信した画面情報がモデルの学習に使われないか等)を事前に確認しておく必要があります。
実行頻度とAPIコストの試算
ブラウザ操作AIエージェントは、1回のタスク完了までに「スクリーンショット撮影 → 画像入力 → LLM推論 → 操作」を何十回も繰り返す場合があります。
画像認識を含むマルチモーダル推論はトークン消費量が大きいため、頻繁に連続実行するとAPIコストが想定以上に膨らむことがあります。定常的に大量処理を行う業務であれば、固定費型のサービスやオープンソースのローカルLLM活用、従来型スクリプトとの組み合わせを検討すると良いでしょう。
まとめ:目的に応じた適切なツールの選択
ブラウザ操作AIエージェントは、従来のRPAや自動化スクリプトが抱えていた「画面の変更に弱い」「事前のルール設計が大変」という課題を解消する革新的なアプローチです。
用途に応じた選び方のポイント
- 自社で細かく制御・カスタマイズしたい場合:Browser Use などのオープンソースフレームワーク
- 手軽に単発のWeb作業を代行させたい場合:OpenAI Operator などのクラウド型Webエージェント
- デスクトップアプリも含めて全体を動かしたい場合:Claude Computer Use などのOS操作技術
- リサーチや競合調査を深掘りしたい場合:Perplexity Comet などの検索特化型ブラウザ
- 決まりきった大量転記・高速処理:従来型RPAや Playwright スクリプトの併用
「何でもAIエージェントに任せる」のではなく、高速・正確さが求められる部分は従来型ツールを活用し、状況判断や柔軟な対応が求められる部分にAIエージェントを組み込むハイブリッドな設計を行うことが、業務効率化を成功させる鍵となります。


