















ReactやVue、AngularなどのJavaScriptフレームワークで作られたWebサイトのSEO対策を調べていると、「Rendertron(レンダートロン)」や「ダイナミック・レンダリング(Dynamic Rendering)」という技術用語を目にすることがあります。
2019年前後にGoogle公式ブログや国内大手Webサービスの開発者ブログでも取り上げられ注目を集めたツールですが、「そもそもどんな仕組みで動くものなの?」「今から新しいサイトに導入しても大丈夫なの?」と疑問に感じている方も多いのではないでしょうか。
本記事では、Rendertronの役割と仕組みを初心者の方にもイメージしやすいように図解で噛み砕いて解説したうえで、実際の企業導入事例から見えたメリットと運用の苦労、さらには「開発終了(アーカイブ)となった現在の状況と現代の推奨アプローチ」まで順を追って整理します。
まずは結論!Rendertron(レンダートロン)を一言でいうと?
一言でいうと、Rendertron(レンダートロン)とは、「JavaScriptで動くWebページを、サーバーの裏側に置いたChromeブラウザで事前に開いて、検索ロボットでもすぐに読める『完成済みの静的HTML』へ変換してくれるGoogle製のオープンソースツール」です。
レストラン(ミールキット)に例えると…
JavaScriptを多用するWebサイト(SPA)は、いわば「お客さんのテーブルで仕上げ調理をするミールキット」のようなものです。人間のブラウザは手元でJavaScriptを動かして調理できますが、検索ロボットやSNSの巡回ボットは「調理前の空のお皿とレシピだけ渡されても中身が分からない!」と困ってしまうことがありました。
そこで、人間が来たときはミールキット(SPA)をそのまま出し、ロボットが来たときだけ裏方のシェフ(Rendertron)が代わりに調理して、盛り付け済みの料理(静的HTML)を出してくれる仕組み――これがRendertronの役割です。
先に知っておきたい現在のステータス(重要)
Rendertronは2018〜2020年頃のSPA普及期に多くのWebサービスを支えた歴史的に重要なツールですが、2022年10月にGitHub公式リポジトリがアーカイブ(開発終了)となり、現在Googleもダイナミック・レンダリングを「一時的な回避策(非推奨)」と位置づけています。これから新規開発するサイトでは、後半で紹介するSSR(サーバーサイドレンダリング)やSSG(静的サイト生成)を選ぶのが現在の標準です。
なぜRendertronが必要とされたのか?(SPAとSEOの壁)
Rendertronが登場した背景を理解するカギは、モダンなWeb開発で急速に広まった「SPA(Single Page Application:シングルページアプリケーション)」の仕組みにあります。
従来のWebサイトでは、ページを開くたびにサーバー側で文字や画像タグが書き込まれたHTMLファイルを作ってブラウザへ送っていました。それに対してSPA(クライアントサイドレンダリング:CSR)では、最初にサーバーから送られてくるHTMLは次のような「ほぼ空っぽの箱」だけです。
<!-- SPAで最初にサーバーから届くHTMLのイメージ(中身がまだ空っぽ) -->
<!DOCTYPE html>
<html lang="ja">
  <head>
    <meta charset="UTF-8">
    <title>読み込み中...</title>
  </head>
  <body>
    <div id="app"></div>
    <script src="/bundle.js"></script>
  </body>
</html>
人間のユーザーがChromeやSafariでこのページを開くと、後から読み込まれた bundle.js(JavaScript)がAPIから商品データや記事本文を取り寄せ、ブラウザ上で画面要素を動的に組み立てます(ブラウザがHTML要素を書き換える仕組みについてはDOMの仕組みと役割でも詳しく解説しています)。一度読み込めばページ移動がアプリのように軽快に動くため、ユーザー体験の面では大きな魅力がありました。
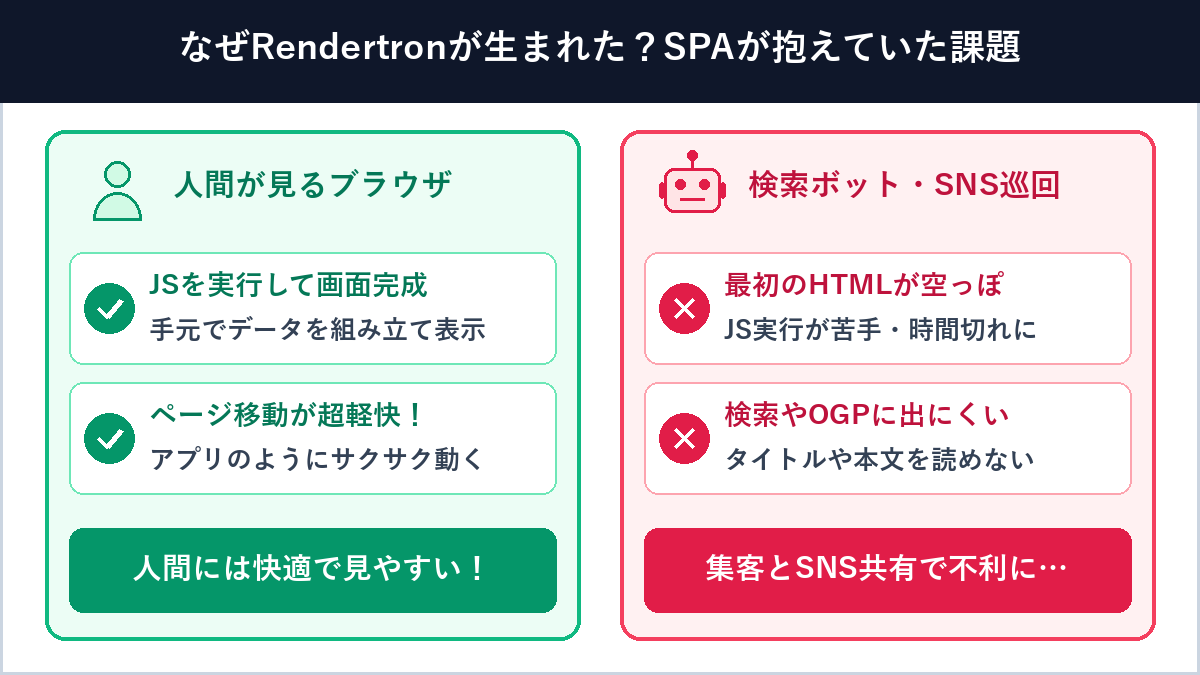
ところが2017〜2019年当時、検索エンジンのクローラー(当時のGooglebotやBingbotなど)や、X(旧Twitter)・Facebook・LINEといったSNSのリンクプレビュー取得ボットには次のような弱点がありました。
- 検索エンジンに中身が正しく登録(インデックス)されない:JavaScriptの実行に対応していないクローラーや、重い通信の完了前にタイムアウトしてしまうクローラーからは
<div id="app"></div>だけの空ページに見えてしまい、検索順位や集客に悪影響が出ていました。 - SNSでシェアしてもタイトルや画像(OGPカード)が出ない:SNSのクローラーは原則としてJavaScriptを実行せず最初のHTMLだけを読むため、各ページ固有の商品名やサムネイル画像をJavaScriptで後から書き換えても認識されませんでした。
- 既存の大規模SPAを丸ごと作り直すのは大変:「それならサイト全体をSSR(サーバーサイドレンダリング)に作り直せばいいのでは?」と思えますが、すでに稼働しているSPAをSSR対応へ書き換えるには大きな開発工数とサーバー増強コストがかかります。
この「既存のSPA本体に大きく手を加えず、検索ボットやSNSボットへの対策だけを後付けしたい」という現場の切実なニーズに応えるためにGoogleが公開したのがRendertronでした。
Rendertronと「ダイナミック・レンダリング」が動く仕組み
Google検索セントラル公式ブログの解説記事(Rendertron を使用したダイナミック レンダリング)でも紹介されたとおり、Rendertronは「ダイナミック・レンダリング(Dynamic Rendering:動的レンダリング)」と呼ばれる構成を実現するためのエンジンとして動作します。
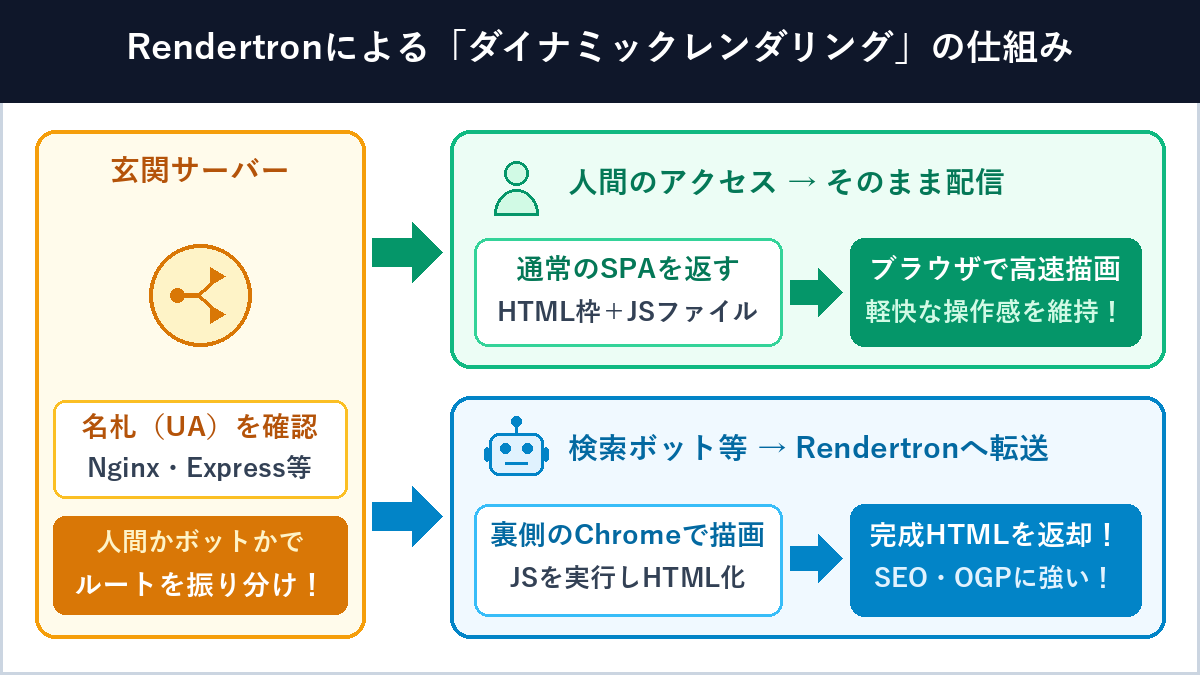
アクセス元の「名札(User-Agent)」を見て案内先を振り分ける
Webサイトへアクセスが来るとき、通信ヘッダーの中には必ず「User-Agent(ユーザーエージェント)」という名札が含まれています。ここには「iPhoneのSafari」「WindowsのChrome」といったブラウザ情報や、「Googlebot」「bingbot」「Twitterbot」といったロボットの名前が書かれています。
Webサイトの玄関に立つサーバー(Nginxなどのリバースプロキシや、Node.jsのExpressサーバー)がこの名札をチェックし、人間のブラウザならそのまま通常のSPAファイルを返し、登録リストに一致するボットなら裏側のRendertronサーバーへリクエストを転送します。
裏側のHeadless Chrome(Puppeteer)がHTMLを書き出して返却する
Rendertron本体の正体は、Node.js(Koa)とブラウザ自動操作ライブラリ「Puppeteer」、そして「Headless Chrome(画面ウィンドウを持たないサーバー実行用のChrome)」を組み合わせた独立したWebサーバーです。
Rendertronに対して https://rendertron.example.com/render/https://shop.example.com/items/123 のように変換したいURLを渡すと、Rendertron内部のChromeがそのページを開いてJavaScriptやAPI通信を実行します。そして通信が落ち着いたタイミングを見計らい、出来上がった画面のDOM構造を1枚の静的なHTML文字列として書き出し(シリアライズ)、ボットへ返却します。
当時の代表的な実装イメージ(Expressミドルウェアの例)
Google公式ブログでも紹介されていたNode.js(Express)向けの公式ミドルウェア rendertron-middleware を使うと、当時わずか十数行のコードを追加するだけでボットの振り分けを組み込むことができました。
// ExpressサーバーにRendertronの振り分け処理を組み込む当時のコード例
const express = require('express');
const rendertron = require('rendertron-middleware');
const app = express();

// 検索ボット・SNSクローラーからのアクセス時のみRendertronへ転送する
const botList = rendertron.botUserAgents.concat(['googlebot']);
app.use(
  rendertron.makeMiddleware({
    proxyUrl: 'https://your-rendertron-instance.example.com/render',
    userAgentPattern: new RegExp(botList.join('|'), 'i'),
  })
);

// 一般ユーザーのアクセスには通常のSPA静的ファイルをそのまま配信する
app.use(express.static('public'));
app.listen(8080);
開発現場ではどう使われた?一休.comの導入事例に学ぶメリットと苦労
仕組みだけを見ると「前段にRendertronサーバーを置くだけで解決する魔法のツール」のように思えますが、大規模な商用サイトで実際に運用するとどのようなメリットや壁があったのでしょうか。
国内における代表的な実践記録として広く知られているのが、一休.com Developers Blogで2019年3月に公開された技術記事(Rendertron導入でDynamic Renderingしている話)です。同記事で共有されている知見は、ダイナミック・レンダリングの光と影を理解するうえでとても参考になります。
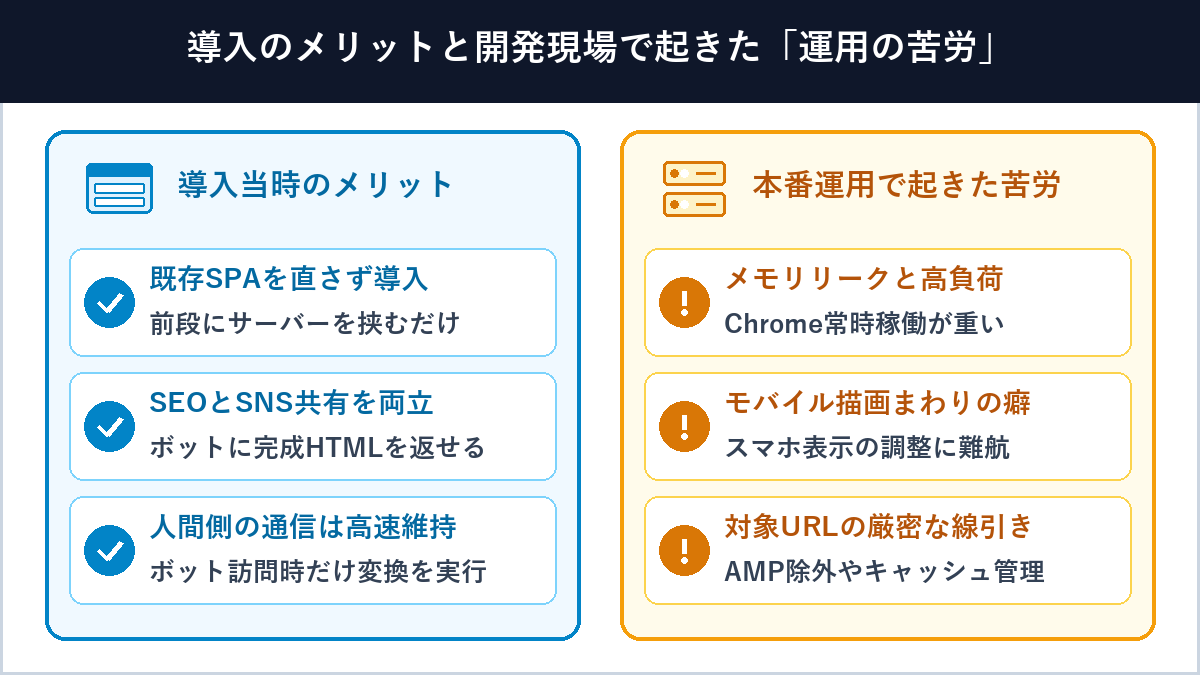
なぜ最初からSSRにせずRendertronを選んだのか(当時の合理的な判断)
当時、一休.comや一休.comレストランのスマートフォン向け検索結果画面などでは、Ajax化(クライアント側での描画)を進めることで人間のユーザーに対する表示パフォーマンスを大きく向上させていました。しかしその反面、検索エンジンのクローラーによるページ内容の認識やOGPなどのメタタグ反映に課題が生じていました。
もし全リクエストをSSR(サーバーサイドレンダリング)に切り替えればクローラー問題は解決しますが、今度は一般ユーザーの膨大なアクセスすべてをサーバー側で描画することになり、サーバー負荷の上昇やレスポンス低下を招く恐れがありました。そのため、「人間のアクセスは軽快なクライアント描画のまま維持し、クローラーが来たときだけNginx等で振り分けてRendertronを通す」という選択は非常に理にかなっていたのです。
本番運用だからこそ見えた「現場ならではの苦労とハマりどころ」
一方で、実際にプロダクション環境へ投入して運用する中では、次のような現場ならではの苦労があったことも率直に語られています。
- Headless Chromeのメモリリークと負荷対策:Rendertronは裏側で本物のChromeプロセスを動かすため、クローラーからの大量アクセスをさばき続けるとメモリ使用量が徐々に膨らむ(メモリリーク)事象が発生しやすく、キャッシュの活用やインスタンス管理などのインフラ運用に工夫が求められました。
- モバイル向け描画(エミュレーション)まわりの不具合:スマートフォン向け画面を正しく描画させる際、公開されて間もなかった当時のRendertronにはモバイルエミュレーションまわりのバグが潜んでおり、原因調査や回避対応に苦労したというエピソードが紹介されています。
- AMPページとの競合など「適用範囲の線引き」:モバイル高速表示規格であるAMPページにまでRendertronを通してしまうと、AMPのJavaScriptが実行された後のHTMLがクローラーへ返ってしまい、「正しいAMPのフォーマットではない」とエラー判定される問題が起きました。そのためNginxなどの振り分け設定で「どの画面には適用し、どの画面は対象外にするか」を厳密に管理する必要がありました。
Rendertronの現在:開発終了(アーカイブ)とGoogleの方針転換
ここまでRendertronの仕組みと活躍の歴史を見てきましたが、実務においてもっとも押さえておくべきなのが「2022年以降の大きな方針転換」です。
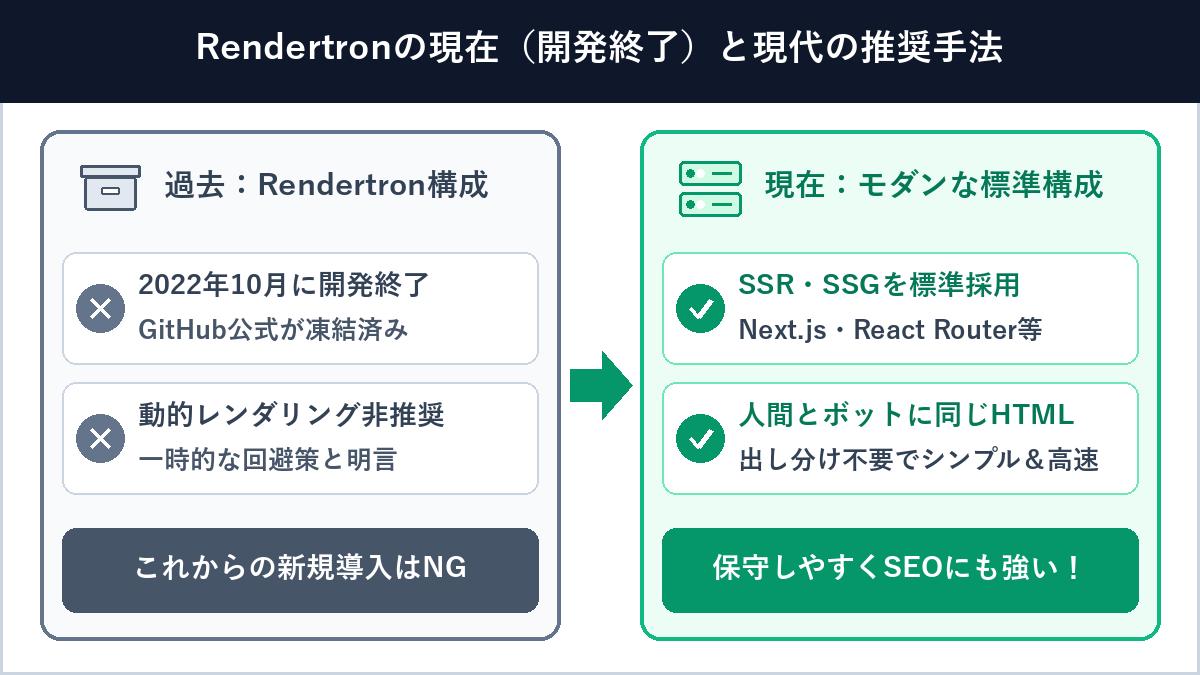
GitHub公式リポジトリはアーカイブ(開発終了)済み
Googleが管理していたGitHubリポジトリ(GoogleChrome/rendertron)は、2022年10月6日をもって公式にアーカイブ(読み取り専用・メンテナンス終了)となりました。以降は依存パッケージのセキュリティ更新や最新のChromiumバージョンへの追従も行われていないため、これから新しくRendertronをサーバーに構築することは避けるべきです。
Google公式ドキュメントでも「ダイナミック・レンダリングは非推奨」へ
ツールの開発終了と前後して、Google検索セントラルの公式ガイドラインも大きく書き換えられました。現在Googleは、ダイナミック・レンダリングを「長期的な解決策ではなく、あくまで一時的な回避策(ワークアラウンド)であり推奨しない」と明記しています。その背景には次の3つの変化があります。
- Googlebot自体の大幅な進化:かつてのGooglebotは古いChrome(Chrome 41相当)でページを描画していたため最新のJavaScriptでつまずきがちでしたが、2019年後半以降は常に最新のChromiumエンジンへ自動更新される「エバーグリーン(Evergreen)Googlebot」へ進化し、一般的なJavaScriptの実行能力が大きく向上しました。
- システム構成の複雑化と保守コスト:一休.comの事例でも見られたとおり、本来のWebアプリとは別にHeadless Chrome基盤やキャッシュ層、ボット判定リストを維持・監視し続ける負担が決して小さくなかったためです。
- 人間とボットで見える内容が食い違うリスク:Rendertron側のキャッシュが古いままであったり描画タイムアウトが起きたりすると、人間が見ている画面とボットが受け取るHTMLの内容にズレが生じ、意図せずSEO評価を落とすトラブルにつながりやすいためです。
これからSPAのSEO・OGP対策をするなら?現代の推奨アプローチ
「では、今まさにReactやVueで作っているサイトのSEOやSNSシェア(OGP)に対応したい場合や、社内に残っている古いRendertron環境を置き換えたい場合はどうすればいいの?」という疑問に向けて、現在の実務で選ばれている3つのアプローチを整理します。
新規開発・リニューアルなら「SSR / SSG / ハイブリッド構成」を採用する
現在の第一選択でありGoogleも推奨しているのが、Next.js(React)、React Router v7(旧Remix統合)、Nuxt(Vue)、Angular SSRなどのモダンフレームワークを使い、アプリケーション自体にSSR(サーバーサイドレンダリング)やSSG(静的サイト生成)を組み込む方法です。
2019年当時に比べてCDNエッジキャッシュやフレームワークの描画性能が飛躍的に進化したため、人間にも検索ボットにも「最初からデータとメタタグが入った高速なHTML」を同じルートで配信でき、初期表示スピード(Core Web Vitals)も向上します。
また、「全ページをSSRにするとサーバー負荷が心配」という場合でも、現在は「集客用の公開ページ(ToC画面)だけSSRやSSGにし、ログイン後の管理画面やマイページはSPAにする」という使い分けが1つのフレームワーク内でスマートに実現できます(詳しい設計方法はReact Routerで「ToC向け画面はSSR、管理画面はSPA」とは?専門用語と使い分けの仕組みで解説しています)。
SNSシェア時のカード表示(OGP)だけが目的の場合:エッジでのメタタグ差し替え
Google検索のクローラーはJavaScriptを読めるようになりましたが、注意したいのがX(旧Twitter)・LINE・Facebook・Slack・DiscordなどのSNSプレビュー取得ボットは、現在でもJavaScriptを実行しないという点です。
もし「既存のSPAサイトで、URLがSNSに貼られたときのタイトルとサムネイル画像(OGPタグ)だけ正しく出したい」というケースであれば、重いHeadless Chromeを動かす必要はありません。Cloudflare Workersなどの軽量なエッジ関数や配信サーバー側で、HTMLの <head> 内にある <meta property="og:..."> の文字列だけをAPIデータから埋め込んで返す方式なら、非常に低コストかつ高速に解決できます。
どうしても改修できない古い大規模SPAを延命する場合:保守されている代替基盤へ
「数年後にリニューアル予定だが、それまでの間、本体に手を入れられないレガシーSPAのクローラー対策を維持しなければならない」という事情がある場合は、開発が止まってセキュリティ更新のないRendertronを使い続けるのではなく、Prerender.ioなどの継続メンテナンスされているマネージド型プリレンダリングサービスや、最新のPlaywright+キャッシュ基盤へ段階的に切り替えるのが安全な移行パスとなります。
| 比較項目 | 過去:Rendertron(動的レンダリング) | 現在:モダンSSR / SSG構成 |
|---|---|---|
| 仕組みの概要 | 人間にはSPA、ボットには裏側のChromeで変換した静的HTMLを出し分ける | サーバーまたはビルド時にHTMLを生成し、人間にもボットにも同じHTMLを届ける |
| 開発・推奨状況 | 2022年10月に開発終了・Google非推奨 | 現在の標準・Google公式推奨 |
| 人間の初回表示速度 | CSRのままなので初回読み込みが重くなりやすい | 最初から完成HTMLが届くためスマホでも高速 |
| インフラ運用負担 | Headless Chromeのメモリ管理・UA判定が必要 | アプリ基盤に統合され、CDNキャッシュとも好相性 |
まとめ
本記事のポイント整理
- Rendertron(レンダートロン)は、JavaScript主体のSPAページをHeadless Chromeで事前描画し、検索ボットやSNSクローラー向けに静的HTMLへ変換するGoogle製のオープンソースツール。
- アクセス元の
User-Agentを見て「人間にはSPA、ボットには静的HTML」を出し分けるダイナミック・レンダリングの中核として、2018〜2020年頃に多くの企業サイトで活用された。 - 既存SPAを大きく改修せずに導入できるメリットがあった反面、Chrome常時稼働によるメモリ管理や対象URLの線引きなど本番運用ならではの難しさも伴っていた。
- 2022年10月にRendertronは開発終了(アーカイブ)となり、Googleも現在はダイナミック・レンダリングを非推奨としているため、これからの開発ではNext.jsやReact RouterなどによるSSR・SSG構成(またはOGP用の軽量なエッジ処理)を選ぶのが適切。
過去の技術記事や既存システムの設計書で「Rendertron」や「Dynamic Rendering」という言葉に出会ったときも、「当時のSPAと検索エンジンのギャップを埋めるために活躍した橋渡し技術であり、今はフレームワーク標準のSSR・SSGへと進化したんだな」と時代背景まで含めて理解しておくと、技術選定やリプレイスの判断がぐっと進めやすくなります。ぜひWebサイト設計の参考にしてみてください。


